
Cairn
Ein selbst gehostetes Panel, in dem das Wissen über ein Projekt die Agenten überlebt, die daran arbeiten. Ein Koordinations-Log, kein Runner: Agenten lesen das Briefing und melden das Ergebnis, und Sie erklären nicht jedem dasselbe aufs Neue. Für Teams, die mehrere Agenten auf denselben Code loslassen.
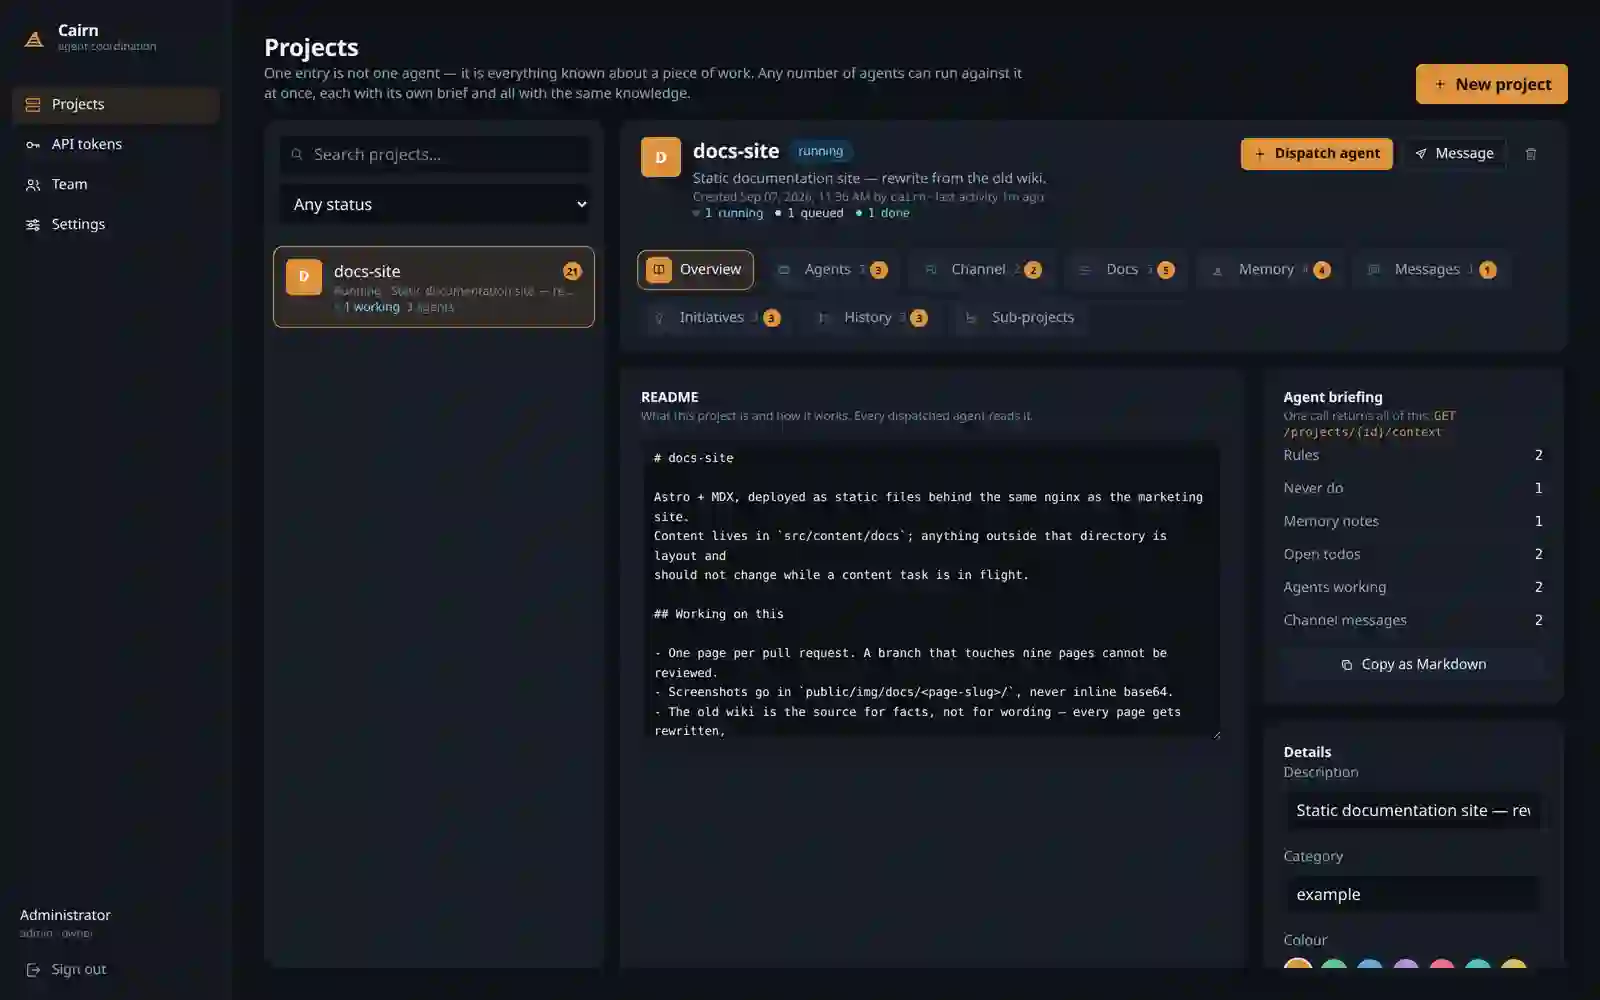
Cairn ist ein selbst gehostetes Panel, in dem das Wissen über ein Projekt die KI-Agenten überlebt, die daran arbeiten. Es ist ein Koordinations-Log, kein Runner: Ein Agent liest das Briefing, macht seinen Teil und meldet das Ergebnis, sodass Sie dem nächsten nicht dasselbe von null erklären. Für Teams, die mehrere Agenten auf denselben Code loslassen und es satt haben, dass das Projektgedächtnis zusammen mit der Session stirbt.
Einführung
Wenn mehrere KI-Agenten an einem Repo arbeiten, hat das Wissen über das Projekt die üble Angewohnheit, zusammen mit der beendeten Session zu sterben. Der erste Agent hat die versteckten Abhängigkeiten kennengelernt, herausgefunden, welcher Teil des Codes fragil ist, und geklärt, wie hier deployt wird. Dann erlischt die Session und dieses Wissen ist weg. Dem nächsten Agenten erklären Sie dasselbe von vorne, und dem übernächsten, und noch einmal, bis Sie zum Flaschenhals für das Wissen über Ihr eigenes Projekt werden.
Das ist kein Problem der Rechenleistung oder des Modells. Kein stärkerer Agent behebt das, denn es ist ein Problem des Gedächtnisses zwischen Sessions, nicht innerhalb einer einzelnen. Cairn zielt genau auf diese Stelle: Es hält das Briefing und die Historie der Entscheidungen an einem Ort, der nicht verschwindet, wenn ein Agent seine Arbeit beendet. Der ganze Rest dieser Fallstudie erzählt davon, warum es bewusst ein Log ist und nicht noch ein Orchestrator.
Wissen, das mit der Session stirbt
Eine Agenten-Session ist von Natur aus flüchtig. Sie sammelt Kontext, baut ihre Arbeit darauf auf, und dann endet sie und der ganze Kontext verdampft. Bei einem Agenten ist das kein Problem: Sie erinnern sich an ihn. Bei fünf, die nacheinander oder parallel in dasselbe Repo einsteigen, fängt jeder bei null an und jeder entdeckt dieselben Minen aufs Neue. Dieselbe fragile Migration, denselben nicht offensichtlichen Deploy, dieselbe Abhängigkeit, die nur in einer bestimmten Reihenfolge hochgeht.
Der natürliche Reflex ist, es ins README zu schreiben oder in den Prompt einzufügen. Nur altert ein README schnell, und ein Prompt stirbt mit dem Chatfenster. Gebraucht wurde ein Ort, der mit dem Projekt wächst und die einzelnen Sessions überlebt: etwas, in das ein Agent beim Eintritt nach Kontext schaut und dem er beim Verlassen anhängt, was er getan hat.
Cairn ist bewusst kein Runner. Es startet keine Agenten, verwaltet ihre Prozesse nicht und versucht nicht, ihre Umgebung zu sein. Es ist ein Koordinations-Log: ein Ort, in den ein Agent nach Kontext schaut und in den er zurückschreibt, was er getan hat. Diese Grenze ist seine ganze Stärke.
Ein Log, kein Runner
Es wäre leicht gewesen, daraus noch einen Orchestrator zu machen, der Agenten selbst startet und versucht, sie zu dirigieren. Darauf haben wir bewusst verzichtet, denn Runner haben ein vorhersehbares Schicksal: Sie verdrahten sich tief in Ihre Umgebung, nehmen immer mehr über sie an und werden schnell zu einer Sache, die selbst gewartet werden muss. Statt Gedächtnis zu geben, nehmen sie Zeit.
Ein Koordinations-Log ist das Gegenteil: einfach, passiv und niemandem im Weg. Der Agent lebt weiter dort, wo er es sonst tut, in Ihrem Terminal oder Ihrer Pipeline, macht seine Arbeit in seiner eigenen Umgebung, und Cairn gibt ihm nur Gedächtnis und einen Ort für den Bericht. Es gibt hier keine Orchestrierungsmagie, die in einer Demo funktioniert und an einem echten Projekt zerbricht, weil es überhaupt keine Orchestrierung gibt.
Was es hält und was bewusst nicht
| Rolle | Cairn tut das | Cairn tut das nicht |
|---|---|---|
| Kontext | hält das Briefing und die Entscheidungshistorie | rät den Kontext nicht für Sie |
| Koordination | ein Log der Einträge pro Projekt, der Reihe nach | startet und verwaltet keine Agentenprozesse |
| Hosting | Sie hosten es selbst, die Daten bleiben Ihre | schickt Ihren Code nicht in fremde Cloud |
| Sichtbarkeit | ein Ort für das, was erledigt und offen ist | ersetzt weder Ihr Repo noch CI |
Die Schleife Briefing, Arbeit, Bericht
Im Herzen liegt ein Koordinations-Log pro Projekt. Statt das Wissen im Kopf eines Agenten oder in einer Chat-Session zu halten, schreiben Sie es einmal als Briefing auf, und jeder nächste Agent beginnt damit, es zu lesen. Wenn er fertig ist, fügt er seinen eigenen Eintrag hinzu: was er getan hat, wie der Stand ist, was für den nächsten offen bleibt. Das Log wächst und wird zum Gedächtnis des Projekts, unabhängig davon, welche Session gerade lebt.
Sie legen ein Projekt an und beschreiben es einmal: was es ist, wo die Grenzen liegen, worauf zu achten ist.
jeder neue Agent startet aus demselben Kontext, ohne dass Sie ihn von Hand wiederholen.
er erledigt seine Aufgabe in seiner eigenen Umgebung, denn Cairn startet ihn weder noch schränkt es ihn ein.
er hängt das Ergebnis an das Log an: was er geändert hat, was funktioniert, was noch zu tun ist.
der folgende Agent liest das Briefing plus alle Berichte und steigt mit dem vollen Bild in die Arbeit ein.
Der Schlüssel ist, dass ein Eintrag kein freier Text ist, sondern eine kurze Struktur mit einem Zustand und einer Liste dessen, was für den nächsten offen ist. Dadurch lässt sich das Log für eine Maschine und für einen Menschen gleich schnell lesen, und der nächste Agent muss nicht raten, wo die vorherige Runde aufgehört hat.
Skalierung, die mit dem Projekt wächst
Der Unterschied wird erst über die Distanz sichtbar. Ohne gemeinsames Gedächtnis wachsen die Kosten, jeden weiteren Agenten einzuführen, weil Sie jedes Mal von Hand eine immer längere Projekthistorie erklären. Mit Cairn sind diese Kosten flach: Der erste Agent und der zehnte lesen dieselbe Quelle, steigen also mit demselben Bild in die Arbeit ein, unabhängig davon, der wievielte sie in der Reihe sind.
Zeit zur Einarbeitung des nächsten Agenten (orientierend, Minuten)
Das ist der ganze Unterschied zwischen einem Team, das die Zahl der Agenten skaliert, und einem Team, das im eigenen Onboarding ertrinkt. Gedächtnis, das Sessions überlebt, verwandelt das Wissen über das Projekt von etwas, das man jedes Mal rekonstruieren muss, in etwas, das einfach da ist.
Die stille Gedächtnisschicht
Die besten Werkzeuge sind nicht die, die am meisten tun. Es sind die, die eine Sache tun und aus dem Weg gehen.
Ein Team, das mehrere Agenten auf denselben Code loslässt, hört auf, der Flaschenhals für sein eigenes Wissen zu sein. Das Briefing schreiben Sie einmal, nicht bei jedem neuen Chatfenster. Der Agent, der als Dritter auftaucht, weiß genauso viel wie der erste, weil er dasselbe liest. Cairn ist nicht spektakulär und versucht es auch nicht zu sein: Es ist die stille Gedächtnisschicht, die zwischen den Sessions bisher gefehlt hat.
Halten Sie das Briefing kurz und hart: die Projektgrenzen, die fragilen Stellen, die Art, wie deployt wird. Den Rest hängen die Agenten in ihren Berichten an. Ein Briefing, das versucht, alles zu beschreiben, altert genauso schnell wie das README, das es ersetzen sollte.
Weil Sie es selbst hosten, verlassen weder der Code noch die Entscheidungshistorie das eigene Haus in Richtung fremder Cloud. Das Gedächtnis des Projekts bleibt dort, wo das Projekt ist: bei Ihnen. Es ist eine unscheinbare Schicht, aber wenn Sie einmal anfangen, Agenten in Serien loszulassen, fällt es schwer, ohne sie zurückzukehren.
Weitere Projekte
Weitere Projekte aus derselben Kategorie - sehen Sie, wie wir ähnliche Herausforderungen angehen.
Haben Sie ein ähnliches Projekt?
Melden Sie sich - ein Angebot ist kostenlos und kommt innerhalb einer Stunde.