
Pharos
Uptime-Monitoring, eine öffentliche Statusseite und Incident-Handling in einer einzigen Binärdatei (Go + eingebettetes SQLite), mit einem einzigen Befehl aufgesetzt. Zwei Dinge, die es abheben: Incident-Abläufe, die in Discord leben, und Uptime, das nicht zu seinen Gunsten rundet. Offener Code, Self-Hosting.
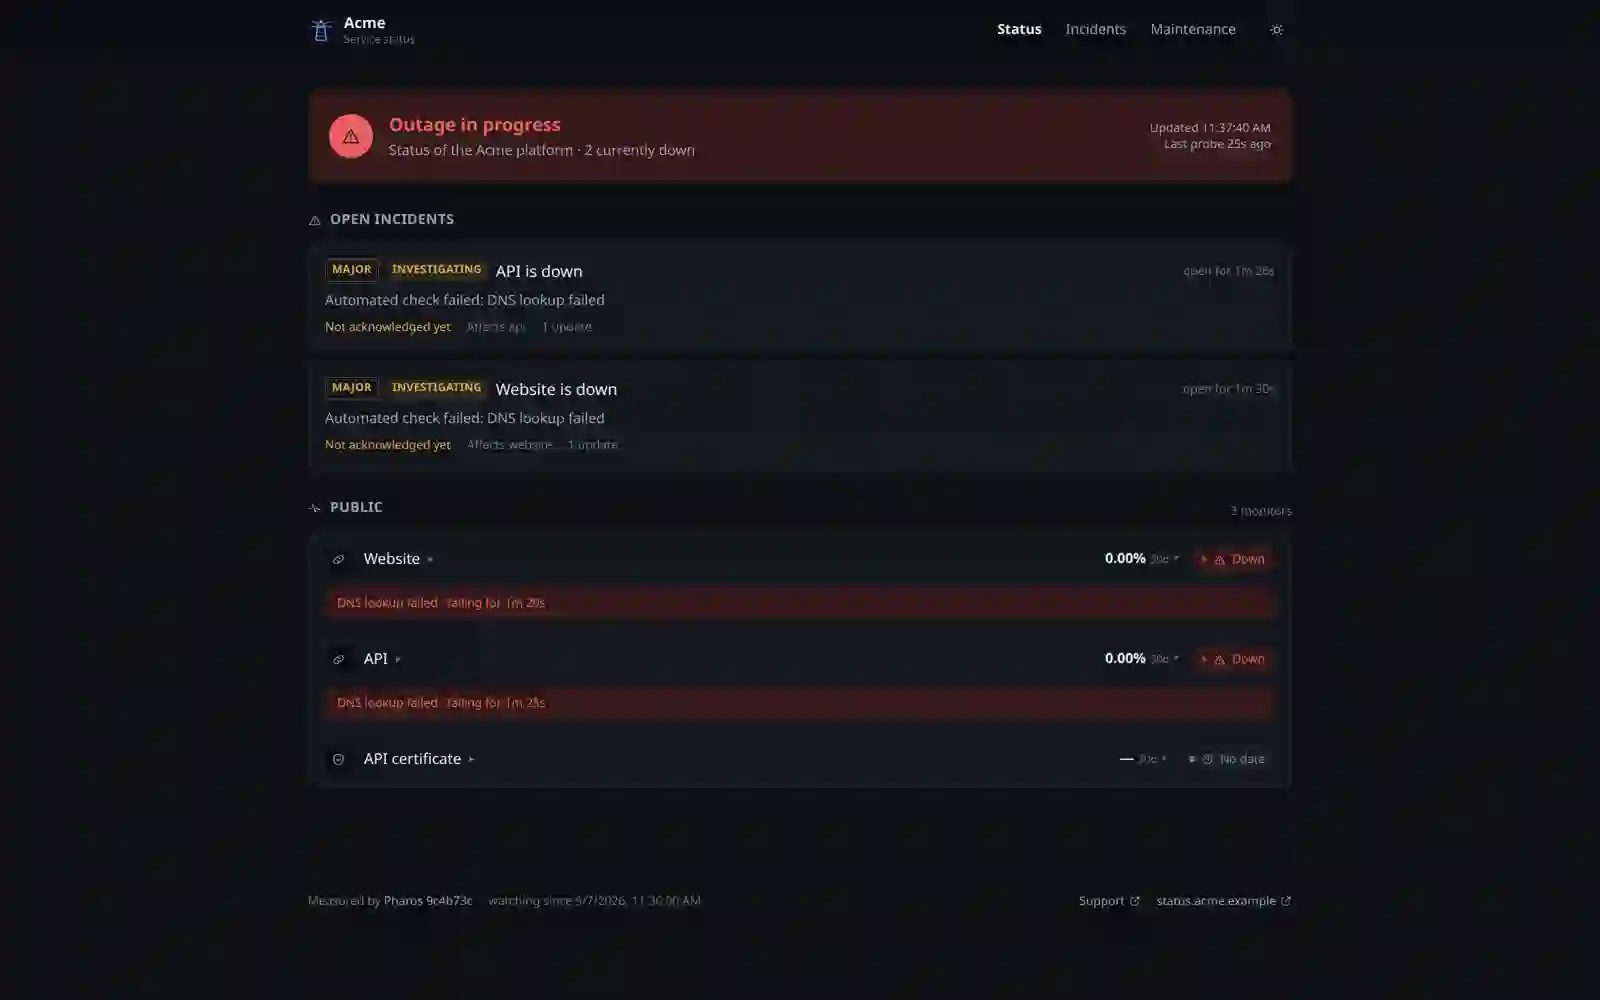
Pharos ist Uptime-Monitoring, eine öffentliche Statusseite und Incident-Bearbeitung, zusammengeführt in einer einzigen Go-Binary mit eingebettetem SQLite. Sie starten ihn mit einem einzigen Befehl, hosten ihn bei sich selbst, und die Uptime rundet nicht zu ihren eigenen Gunsten auf: Zeit ohne Beobachtung ist nicht "verfügbar", sondern "unbekannt". Incidents führen Sie aus Discord heraus, der Code ist offen, und die Zahl auf der Statusseite bedeutet genau das, was sie sagt.
Einführung
Statusseiten haben eine hässliche Eigenschaft: fast alle lügen zu ihren eigenen Gunsten. Wenn eine Sonde einen Dienst nicht mehr abfragt, weil das Monitoring selbst ausgefallen ist oder die Aufbewahrungsfrist abgelaufen ist, zählen die meisten Tools diese Lücke einfach nicht in die Statistik ein. Das Ergebnis ist ein Diagramm, das 100 Prozent Verfügbarkeit über einen Zeitraum zeigt, in dem niemand irgendetwas gemessen hat. Dazu kommen Wartungsfenster, die den Balken auf magische Weise nie beschädigen, und plötzlich haben Sie ein Panel, das großartig aussieht und nichts bedeutet.
Pharos haben wir andersherum gebaut. Es ist ein Werkzeug, das Sie mit einem einzigen Befehl aufsetzen, auf Ihrem eigenen Server behalten und dem man glauben kann, denn wenn es etwas nicht weiß, dann sagt es, dass es das nicht weiß. Es ist nicht noch ein weiteres Cloud-Dashboard mit Abonnement und fremder Aufbewahrung, sondern eine einzige Datei, die Sie neben den Rest Ihrer Dienste kopieren und starten. Der ganze Rest dieser Fallstudie erzählt davon, wie eine einzige Entscheidung in der Formel zur Verfügbarkeitsberechnung den Charakter des gesamten Produkts verändert.
Stille ist keine Verfügbarkeit
Klassisches Monitoring kennt zwei Zustände: der Dienst läuft oder er läuft nicht. Das ist bequem, bis Sie fragen, was passiert, wenn das Monitoring überhaupt nicht hinschaut. Denn dann muss das Werkzeug etwas mit dieser Zeit anfangen, und die Standardwahl tappt fast immer in dieselbe Falle: Sie behandelt die Stille als Erfolg und rechnet sie still und leise dem "up"-Balken zu. So entstehen diese absurden 100 Prozent für einen Monat, in dem in Wirklichkeit die Hälfte der Daten nicht existiert.
Bei uns hat jeder Zeitraum im Leben eines Dienstes drei Zustände, nicht zwei. Verfügbar, Ausfall und ohne Beobachtung. Der dritte ist der ganze Kern: Es ist die Zeit, in der wir keine Daten gesammelt haben, also haben wir kein Recht zu behaupten, dass alles in Ordnung war. Statt sie nach oben aufzurechnen, zeigen wir sie unmittelbar als eigenen Teil des Zeitraums. Wartungsfenster werden markiert, löschen aber keine Ausfälle aus der Historie, sie trennen nur das Geplante vom Unerwarteten.
Die meisten Statusseiten berechnen die Verfügbarkeit als "up"-Zeit geteilt durch "up plus down"-Zeit. Pharos berechnet sie als "up"-Zeit geteilt durch die tatsächlich beobachtete Zeit und legt den nicht sondierten Abschnitt separat als "unbekannt" ab. Das ist ein Unterschied von einer Zeile in der Formel und der ganze Unterschied im Vertrauen in die Zahl.
Wie wir ehrliche Uptime berechnen
Die Aufteilung in drei Zustände klingt nebensächlich, bis Sie sie an einem konkreten Fenster sehen. Nehmen Sie einen Tag, an dem ein Dienst die meiste Zeit verfügbar war, für einen Moment lag, und für einen Abschnitt niemand ihn sondiert hat, weil sich die Monitoring-Maschine selbst neu gestartet hat. Ein naiver Zähler summiert das Verfügbare mit dem Unbeobachteten und wirft effektvolle, hohe Prozentzahlen aus. Ein ehrlicher Zähler zeigt weniger und fügt hinzu, dass er eine Zeit lang nichts wusste.
Woraus ein Fenster wirklich besteht
Derselbe Tag, zwei Zähler
Derselbe Tag, durch zwei verschiedene Formeln geschickt, ergibt zwei völlig unterschiedliche Zahlen. Und das ist keine Kosmetik: Es ist der Unterschied zwischen einem Bericht, dem ein Kunde vertrauen kann, und einem Bericht, der nur im Meeting gut aussieht. Wir haben den weniger effektvollen gewählt, weil nur er etwas bedeutet.
Derselbe Tag, zwei Zähler (Prozent Verfügbarkeit)
Eine Datei, die Sie mit einem Befehl aufsetzen
Das größte praktische Problem von Status-Tools ist, wie viel man um sie herum aufsetzen muss, bevor sie überhaupt etwas anzeigen. Eine separate Datenbank, eine Queue, ein Worker, ein Panel, ein Reverse Proxy. Pharos geht in die entgegengesetzte Richtung: Das gesamte Monitoring, die Historie, die Statusseite und die Incident-Bearbeitung stecken in einer einzigen statischen Go-Binary, und die Daten hält ein eingebettetes SQLite. Es gibt keine separate Datenbank zum Aufsetzen und Beaufsichtigen, keine Runtime zum Installieren. Sie kopieren die Binary, starten sie, und arbeiten.
Diese Einfachheit ist kein Sparen an Funktionen, sondern ein bewusstes Beschneiden der Wartungsfläche. Je weniger bewegliche Teile, desto weniger Dinge, die um drei Uhr morgens kaputtgehen können. Ein Deployment, ein Port, ein Log zum Durchsehen, wenn etwas schiefgeht.
Stack
| Schicht | Wahl | Warum so |
|---|---|---|
| Kern | Go, eine einzige statische Binary | keine Runtime-Abhängigkeiten, Sie kopieren und starten |
| Daten | in die Binary eingebettetes SQLite | keine separate Datenbank zum Aufsetzen und Beaufsichtigen |
| Sonden | HTTP und TCP im Hintergrund | einfache Checks, die die meisten Dienste abdecken |
| Benachrichtigungen | Discord-Webhooks | das Team ist schon da, kein weiteres Werkzeug nötig |
| Statusseite | aus demselben Prozess ausgeliefert | ein Deployment, ein Port, ein Log |
Sonden im Hintergrund und ein Strom von Ergebnissen
Unter einer ehrlichen Zahl muss eine ehrliche Datenquelle liegen. Pharos fragt Ihre Dienste in festem Intervall über HTTP und TCP ab und speichert jedes einzelne Ergebnis zusammen mit der Antwortzeit und einem Zeitstempel. Wir mitteln nichts im Flug und überschreiben keine Historie, denn genau aus diesem rohen Strom von Stichproben werden später die drei Zustände gebaut. Wenn es für ein Intervall keine Stichprobe gibt, ist dieses Intervall per Definition ohne Beobachtung, nicht per Vermutung.
fragt Ihre Dienste über HTTP und TCP in festem Intervall ab und speichert jedes Ergebnis mit seiner Antwortzeit.
jede Stichprobe liegt separat, mit eigenem Zeitstempel, statt sofort weggemittelt zu werden.
baut die Historie aus drei Zuständen und behandelt Stille nie als Erfolg.
stellt eine öffentliche Statusseite mit einer lesbaren Historie bereit, der Art, die ein Kunde ohne Übersetzer versteht.
wenn sich der Zustand eines Dienstes ändert, landet eine Benachrichtigung auf Discord, genau dort, wo das Team arbeitet.
Beachten Sie zwei Dinge in diesem Ausschnitt. Die Zeit ohne Beobachtung wird im Nenner ausgelassen, nicht nach oben aufgerechnet. Und wenn es überhaupt keine Beobachtung gab, gibt die Funktion NaN zurück statt falscher 100 Prozent, denn keine Daten sind keine Daten, kein Erfolg.
Incidents dort, wo das Team schon ist
Das klassische Ausfallszenario sieht so aus: Etwas fällt aus, jemand sieht es, und das Springen beginnt zwischen dem Monitoring-Panel, dem Messenger und der Statusseite. Drei Fenster, drei Versionen der Wahrheit, und eine große Chance, dass der öffentliche Status von dem abweicht, was das Team wirklich weiß. Pharos schneidet das auf einen Ort zusammen. Einen Incident legen Sie an und führen ihn aus Discord, und die öffentliche Statusseite ist nur ein Abbild dessen, was das Team ohnehin schreibt.
Es gibt kein zweites Werkzeug zu lernen und kein Risiko, dass der Status seinen eigenen Weg geht, denn es ist dieselbe Realität von zwei Seiten gesehen. Meldung, Aktualisierungen und Abschluss erledigen Sie dort, wo Sie ohnehin sitzen, und die Seite aktualisiert sich selbst.
Eine Zahl, der man glauben kann
Ehrliches Monitoring ist nicht das, das immer grün anzeigt. Es ist das, das zugibt, dass es einen Moment lang nicht hingeschaut hat.
Herausgekommen ist ein Werkzeug, das Sie auf einer kleinen Maschine neben den Rest Ihrer Dienste stellen können und über das Sie nicht nachdenken müssen. Eine Datei, eine eingebettete Datenbank, ein Port. Die Zahl auf der Statusseite bedeutet genau das, was sie sagt, und wenn das Monitoring etwas nicht weiß, dann tut es nicht so, als wüsste es es. Für den Kunden, der diese Seite ansieht, ist das der Unterschied zwischen Vertrauen und einer Werbetafel.
Wenn Ihre Statusseite seit Jahren glatte 99.99 Prozent zeigt, lohnt es sich zu prüfen, ob es wirklich so gut ist oder ob einfach niemand die Stille mitzählt. Ein ehrlicher Zähler zeigt fast immer weniger als der, an den wir uns gewöhnt haben, und genau deshalb ist er etwas wert.
Der Code ist offen, Sie können sich also diese ganze Formel selbst durchlesen, statt uns aufs Wort zu glauben. Das ist wohl das Ehrlichste, was ein Werkzeug zum ehrlichen Berechnen der Verfügbarkeit über sich selbst sagen kann.
Weitere Projekte
Weitere Projekte aus derselben Kategorie - sehen Sie, wie wir ähnliche Herausforderungen angehen.
Haben Sie ein ähnliches Projekt?
Melden Sie sich - ein Angebot ist kostenlos und kommt innerhalb einer Stunde.