
Cairn
Un panel autoalojado donde el conocimiento de un proyecto sobrevive a los agentes que trabajan en él. Un registro de coordinación, no un runner: los agentes leen el briefing y reportan el resultado, y tú no explicas lo mismo a cada uno desde cero. Para equipos que lanzan varios agentes sobre el mismo código.
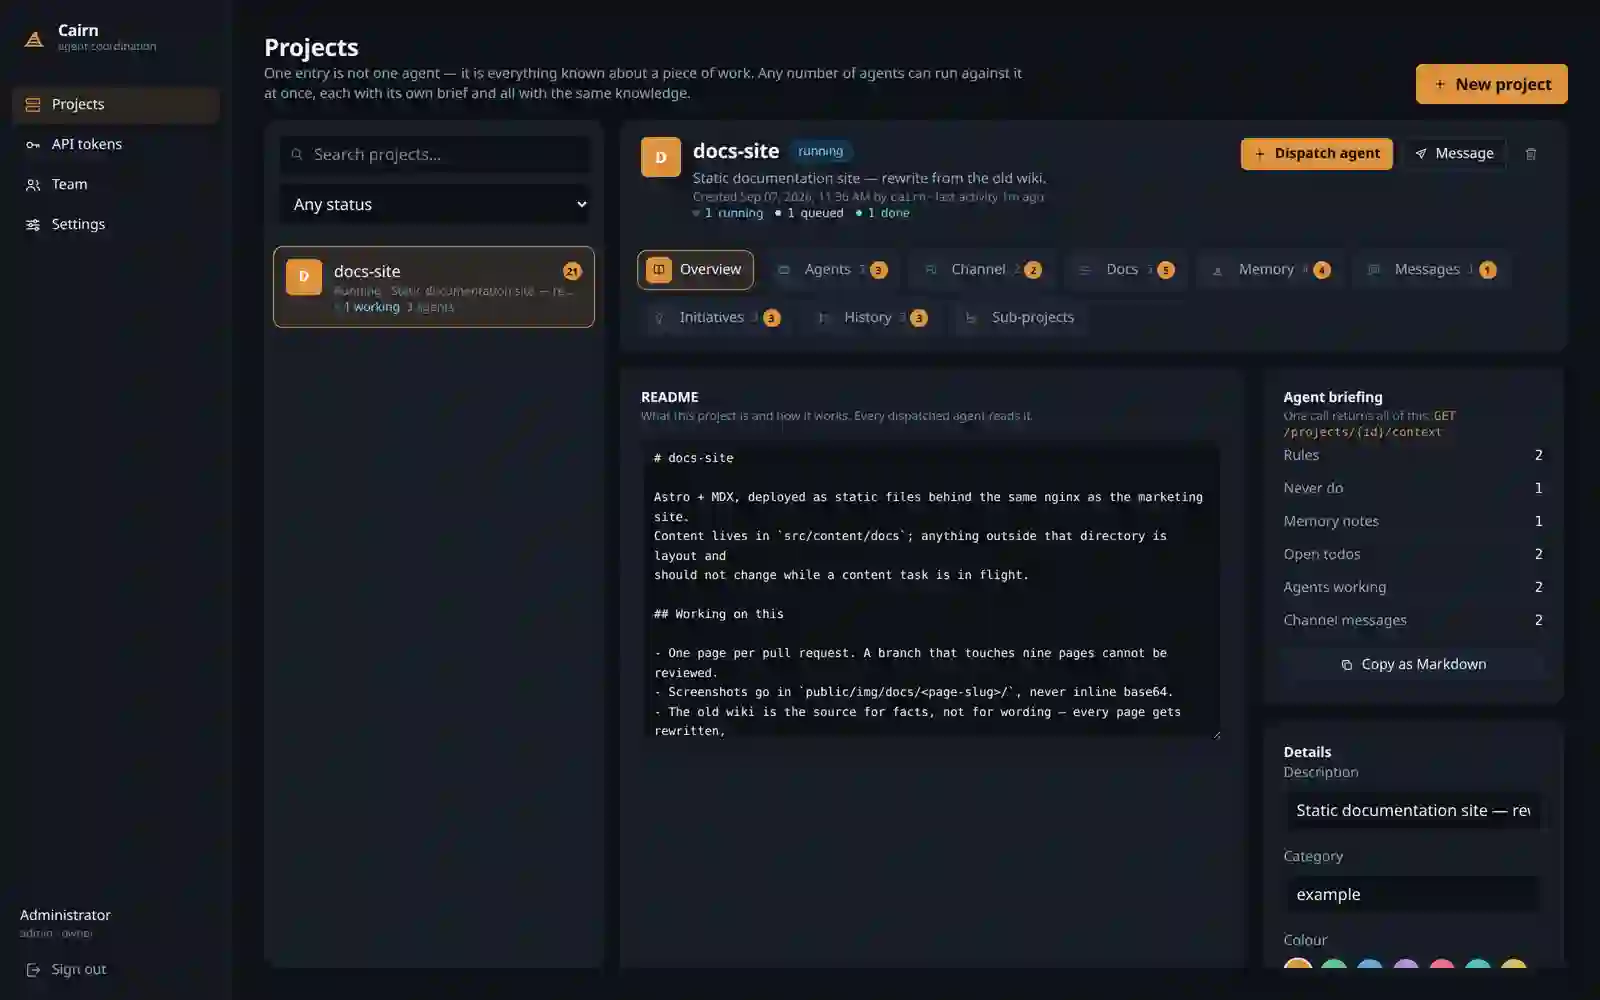
Cairn es un panel autoalojado en el que el conocimiento sobre un proyecto sobrevive a los agentes de IA que trabajan en él. Es un registro de coordinación, no un runner: un agente lee el briefing, hace su parte y reporta el resultado, para que no le expliques lo mismo al siguiente desde cero. Para equipos que lanzan varios agentes sobre el mismo código y están hartos de que la memoria del proyecto muera junto con la sesión.
Introducción
Cuando varios agentes de IA trabajan sobre un mismo repo, el conocimiento sobre el proyecto tiene la fea costumbre de morir con la sesión que terminó. El primer agente conoció las dependencias ocultas, averiguó qué parte del código es frágil, y estableció cómo se despliega aquí. Luego la sesión se apaga y ese conocimiento desaparece. Al siguiente agente le explicas lo mismo desde el principio, y al de después, y otra vez, hasta que te conviertes en el cuello de botella del conocimiento sobre tu propio proyecto.
No es un problema de potencia de cálculo ni de modelo. Ningún agente más potente lo arregla, porque es un problema de memoria entre sesiones, no dentro de una sola. Cairn apunta exactamente a ese punto: guarda el briefing y el historial de decisiones en un solo lugar que no desaparece cuando un agente termina su trabajo. Todo el resto de este caso práctico cuenta por qué es deliberadamente un registro y no otro orquestador más.
Conocimiento que muere con la sesión
Una sesión de agente es efímera por naturaleza. Reúne contexto, construye su trabajo sobre él, y luego termina y todo ese contexto se evapora. Con un solo agente no es problema: lo recuerdas tú. Con cinco que entran en el mismo repo uno tras otro o en paralelo, cada uno parte de cero y cada uno redescubre las mismas minas de nuevo. La misma migración frágil, el mismo despliegue no evidente, la misma dependencia que solo estalla en cierto orden.
El reflejo natural es escribirlo en el README o pegarlo en el prompt. Solo que un README envejece rápido, y un prompt muere con la ventana de chat. Hacía falta un lugar que crece con el proyecto y sobrevive a las sesiones individuales: algo que un agente consulta en busca de contexto a la entrada y a lo que añade lo que hizo a la salida.
Cairn deliberadamente no es un runner. No lanza agentes, no gestiona sus procesos ni intenta ser su entorno. Es un registro de coordinación: un lugar que un agente consulta en busca de contexto y en el que reescribe lo que hizo. Ese límite es toda su fuerza.
Un registro, no un runner
Habría sido fácil convertir esto en otro orquestador más que lanza los agentes por sí mismo e intenta dirigirlos. Renunciamos a ello a propósito, porque los runners tienen un destino previsible: se enganchan en profundidad a tu entorno, asumen cada vez más cosas sobre él, y pronto se convierten en algo que necesita mantenimiento por sí mismo. En lugar de dar memoria, quitan tiempo.
Un registro de coordinación es lo contrario: simple, pasivo y sin estorbar a nadie. El agente sigue viviendo donde vive de costumbre, en tu terminal o tu pipeline, hace su trabajo en su propio entorno, y Cairn solo le da memoria y un lugar para reportar. Aquí no hay magia de orquestación que funciona en una demo y se deshace en un proyecto real, porque no hay orquestación en absoluto.
Qué guarda, y qué deliberadamente no
| Rol | Cairn lo hace | Cairn no lo hace |
|---|---|---|
| Contexto | guarda el briefing y el historial de decisiones | no adivina el contexto por ti |
| Coordinación | un registro de entradas por proyecto, en orden | no lanza ni gestiona los procesos de los agentes |
| Hosting | lo alojas tú, los datos siguen siendo tuyos | no envía tu código a la nube ajena |
| Visibilidad | un solo lugar para lo hecho y lo abierto | no reemplaza ni tu repo ni la CI |
El bucle briefing, trabajo, reporte
En el corazón hay un registro de coordinación por proyecto. En lugar de guardar el conocimiento en la cabeza de un agente o en una sesión de chat, lo escribes una vez como briefing, y cada agente siguiente empieza leyéndolo. Cuando termina, añade su propia entrada: qué hizo, cuál es el estado, qué queda abierto para el siguiente. El registro crece y se convierte en la memoria del proyecto, independiente de qué sesión esté viva en cada momento.
creas un proyecto y lo describes una vez: qué es, dónde están los límites, a qué prestar atención.
cada nuevo agente parte del mismo contexto, sin que lo repitas a mano.
hace su tarea en su propio entorno, porque Cairn ni lo lanza ni lo limita.
añade el resultado al registro: qué cambió, qué funciona, qué queda por hacer.
el agente de después lee el briefing más todos los reportes y entra en el trabajo con la imagen completa.
La clave es que una entrada no es texto libre, sino una estructura corta con un estado y una lista de lo que queda abierto para el siguiente. Así el registro se lee igual de rápido para una máquina y para un humano, y el siguiente agente no tiene que adivinar dónde se detuvo el turno anterior.
Una escala que crece con el proyecto
La diferencia solo se hace visible en la distancia. Sin memoria compartida, el coste de incorporar a cada nuevo agente crece, porque cada vez explicas a mano un historial de proyecto cada vez más largo. Con Cairn ese coste es plano: el primer agente y el décimo leen la misma fuente, así que entran en el trabajo con la misma imagen, sin importar qué número sean en el orden.
Tiempo de incorporación del siguiente agente (orientativo, minutos)
Esa es toda la diferencia entre un equipo que escala el número de agentes y un equipo que se ahoga en su propio onboarding. La memoria que sobrevive a las sesiones convierte el conocimiento sobre el proyecto, de algo que hay que reconstruir cada vez, en algo que simplemente está.
La capa de memoria silenciosa
Las mejores herramientas no son las que hacen más. Son las que hacen una sola cosa y se apartan del camino.
Un equipo que lanza varios agentes sobre el mismo código deja de ser el cuello de botella de su propio conocimiento. El briefing lo escribes una vez, no en cada nueva ventana de chat. El agente que aparece en tercer lugar sabe tanto como el primero, porque lee lo mismo. Cairn no es vistoso y no intenta serlo: es la capa de memoria silenciosa que antes faltaba entre las sesiones.
Mantén el briefing corto y duro: los límites del proyecto, las partes frágiles, la forma de desplegar. El resto lo añaden los agentes en sus reportes. Un briefing que intenta describirlo todo envejece tan rápido como el README que debía reemplazar.
Como lo alojas tú, ni el código ni el historial de decisiones salen hacia la nube ajena. La memoria del proyecto se queda donde está el proyecto: contigo. Es una capa discreta, pero una vez que empiezas a lanzar agentes en serie, es difícil volver atrás sin ella.
Más proyectos
Más trabajos de la misma categoría - mira cómo abordamos retos parecidos.
¿Tiene un proyecto similar?
Escríbenos - el presupuesto es gratuito y llega en una hora.