
Pharos
Monitorización de uptime, página de estado pública y gestión de incidentes en un único binario (Go + SQLite integrado), levantado con un solo comando. Dos cosas lo distinguen: las operaciones de incidentes que viven en Discord y un uptime que no redondea a su favor. Código abierto, autoalojado.
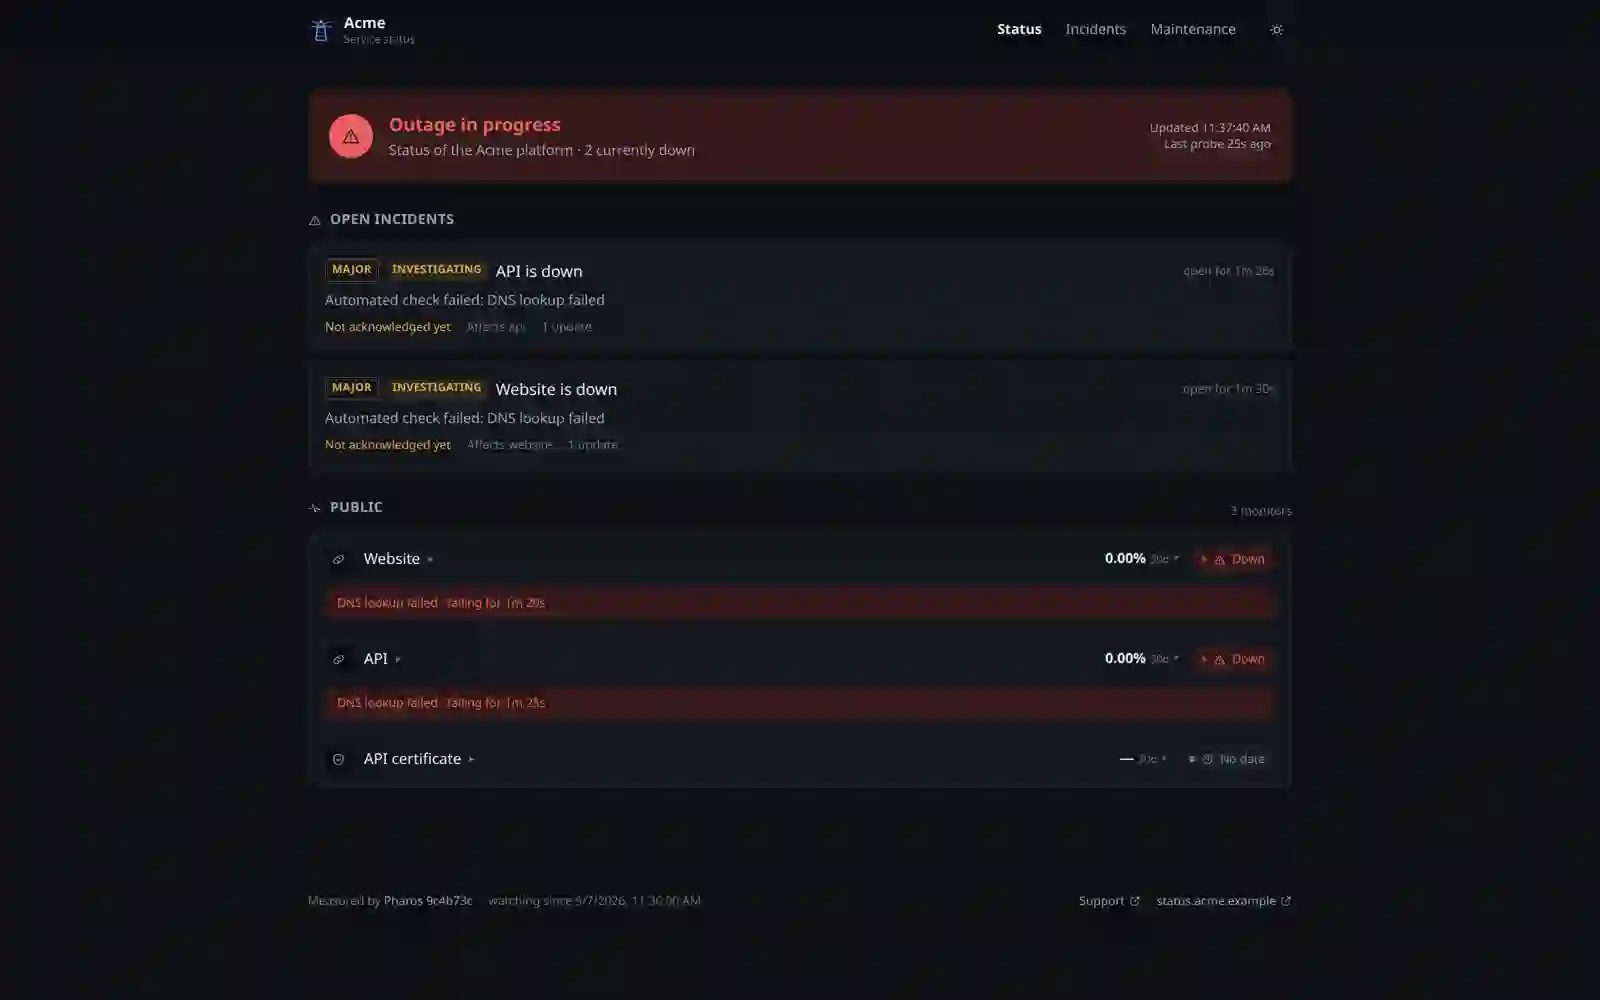
Pharos es monitorización de uptime, una página de estado pública y gestión de incidentes reunidos en un único binario Go con SQLite incorporado. Lo levantas con un solo comando, lo alojas en tu propia máquina, y el uptime no redondea a su favor: el tiempo sin observación no es "disponible", sino "desconocido". Los incidentes los llevas desde Discord, el código es abierto, y el número en la página de estado significa exactamente lo que dice.
Introducción
Las páginas de estado tienen un rasgo feo: casi todas mienten a su favor. Cuando una sonda deja de consultar un servicio, porque la propia monitorización se cayó o se acabó el periodo de retención, la mayoría de las herramientas simplemente no cuentan ese hueco en las estadísticas. El resultado es un gráfico que muestra un 100 por ciento de disponibilidad durante una ventana en la que nadie midió nada. A esto se suman las ventanas de mantenimiento que mágicamente nunca mellan la barra, y de repente tienes un panel que se ve estupendo y no significa nada.
Pharos lo construimos al revés. Es una herramienta que levantas con un solo comando, mantienes en tu propio servidor y en la que realmente se puede confiar, porque cuando no sabe, lo dice. No es otro panel en la nube con suscripción y retención ajena, sino un único archivo que copias junto al resto de tus servicios y ejecutas. Todo el resto de este caso práctico cuenta cómo una sola decisión en la fórmula de cálculo de la disponibilidad cambia el carácter de todo el producto.
El silencio no es disponibilidad
La monitorización clásica conoce dos estados: el servicio funciona o no funciona. Es cómodo hasta que preguntas qué pasa cuando la monitorización no mira en absoluto. Porque entonces la herramienta tiene que hacer algo con ese tiempo, y la opción por defecto cae casi siempre en la misma trampa: trata el silencio como un éxito y lo suma en silencio a la barra "up". Así surgen esos absurdos 100 por ciento de un mes en el que en realidad la mitad de los datos no existe.
En nuestro caso cada tramo de vida de un servicio tiene tres estados, no dos. Disponible, caída y sin observación. El tercero es el quid de todo: es el tiempo en el que no recogimos datos, así que no tenemos derecho a afirmar que todo iba bien. En lugar de sumarlo hacia arriba, lo mostramos directamente como una parte aparte de la ventana. Las ventanas de mantenimiento se marcan, pero no borran las caídas del historial, solo separan lo planificado de lo inesperado.
La mayoría de las páginas de estado calculan la disponibilidad como tiempo "up" dividido por el tiempo "up más down". Pharos la calcula como tiempo "up" dividido por el tiempo realmente observado, y coloca el tramo no sondeado aparte como "desconocido". Es una diferencia de una línea en la fórmula y toda la diferencia en la confianza en el número.
Cómo contamos un uptime honesto
La división en tres estados suena menor hasta que la ves en una ventana concreta. Toma un día en el que un servicio estuvo disponible la mayor parte del tiempo, se cayó por un momento, y durante un tramo nadie lo sondeó porque la máquina de monitorización se reinició sola. Un contador ingenuo suma el tiempo disponible con el no observado y escupe un porcentaje alto y vistoso. Un contador honesto muestra menos y añade que durante un rato no supo nada.
De qué se compone realmente una ventana
El mismo día, dos contadores
El mismo día, pasado por dos fórmulas distintas, da dos números completamente diferentes. Y esto no es cosmética: es la diferencia entre un informe en el que un cliente puede confiar y un informe que solo se ve bien en una reunión. Elegimos el menos vistoso, porque es el único que significa algo.
El mismo día, dos contadores (por ciento de disponibilidad)
Un único archivo que levantas con un comando
El mayor problema práctico de las herramientas de estado es cuánto hay que levantar a su alrededor antes de que muestren algo. Una base de datos aparte, una cola, un worker, un panel, un reverse proxy. Pharos va en la dirección contraria: toda la monitorización, el historial, la página de estado y la gestión de incidentes caben en un único ejecutable Go estático, y los datos los guarda un SQLite incorporado. No hay una base de datos separada que levantar y vigilar, ningún runtime que instalar. Copias el binario, lo ejecutas, y trabajas.
Esa simplicidad no es un ahorro en funciones, sino un recorte deliberado de la superficie de mantenimiento. Cuantas menos piezas móviles, menos cosas que pueden romperse a las tres de la madrugada. Un despliegue, un puerto, un log que repasar cuando algo sale mal.
Stack
| Capa | Elección | Por qué así |
|---|---|---|
| Núcleo | Go, un único ejecutable estático | cero dependencias de runtime, copias y ejecutas |
| Datos | SQLite incorporado en el binario | ninguna base de datos separada que levantar y vigilar |
| Sondas | HTTP y TCP en segundo plano | comprobaciones simples que cubren la mayoría de los servicios |
| Notificaciones | webhooks de Discord | el equipo ya está ahí, no hace falta otra herramienta |
| Página de estado | servida desde el mismo proceso | un despliegue, un puerto, un log |
Sondas en segundo plano y un flujo de resultados
Bajo un número honesto tiene que haber una fuente de datos honesta. Pharos consulta tus servicios a intervalo fijo por HTTP y TCP, y registra cada resultado individual junto con su tiempo de respuesta y una marca de tiempo. No promediamos nada al vuelo y no sobrescribimos el historial, porque es precisamente de ese flujo crudo de muestras del que luego se construyen los tres estados. Si no hay muestra para algún intervalo, ese intervalo está sin observación por definición, no por defecto.
consulta tus servicios por HTTP y TCP a intervalo fijo y registra cada resultado con su tiempo de respuesta.
cada muestra queda aparte, con su propia marca de tiempo, en lugar de promediarse de inmediato.
construye el historial a partir de tres estados y nunca trata el silencio como un éxito.
sirve una página de estado pública con un historial legible, del tipo que un cliente entiende sin traductor.
cuando el estado de un servicio cambia, una notificación llega a Discord, justo donde trabaja el equipo.
Fíjate en dos cosas en este fragmento. El tiempo sin observación se omite en el denominador, no se suma hacia arriba. Y cuando no hubo observación alguna, la función devuelve NaN en lugar de un falso 100 por ciento, porque la ausencia de datos es ausencia de datos, no un éxito.
Incidentes donde el equipo ya está
El escenario clásico de una caída es así: algo se cae, alguien lo ve, y empieza el salto entre el panel de monitorización, el chat y la página de estado. Tres ventanas, tres versiones de la verdad, y muchas probabilidades de que el estado público se aleje de lo que el equipo sabe de verdad. Pharos lo reduce a un solo lugar. Un incidente lo abres y lo llevas desde Discord, y la página de estado pública es solo un reflejo de lo que el equipo escribe de todos modos.
No hay una segunda herramienta que aprender ni riesgo de que el estado vaya por su cuenta, porque es la misma realidad vista desde dos lados. La apertura, las actualizaciones y el cierre los resuelves donde ya estáis, y la página se refresca sola.
Un número en el que se puede confiar
La monitorización honesta no es la que siempre muestra verde. Es la que admite que no estuvo mirando por un momento.
Lo que salió es una herramienta que puedes poner en una máquina pequeña junto al resto de tus servicios y de la que luego puedes dejar de preocuparte. Un archivo, una base de datos incorporada, un puerto. El número en la página de estado significa exactamente lo que dice, y cuando la monitorización no sabe algo, no finge saberlo. Para el cliente que mira esa página, es la diferencia entre la confianza y una valla publicitaria.
Si tu página de estado lleva años mostrando un pulcro 99.99 por ciento, vale la pena comprobar si de verdad va todo tan bien o si sencillamente nadie cuenta el silencio. Un contador honesto muestra casi siempre menos que aquel al que nos acostumbramos, y justo por eso vale algo.
El código es abierto, así que puedes leer toda esa fórmula por ti mismo en lugar de creernos bajo palabra. Es probablemente lo más honesto que una herramienta para contar honestamente la disponibilidad puede decir de sí misma.
Más proyectos
Más trabajos de la misma categoría - mira cómo abordamos retos parecidos.
¿Tiene un proyecto similar?
Escríbenos - el presupuesto es gratuito y llega en una hora.