
Cairn
Un panneau auto-hébergé où la connaissance d'un projet survit aux agents qui y travaillent. Un journal de coordination, pas un runner : les agents lisent le briefing et rapportent le résultat, et vous n'expliquez pas la même chose à chacun depuis le début. Pour les équipes qui lancent plusieurs agents sur le même code.
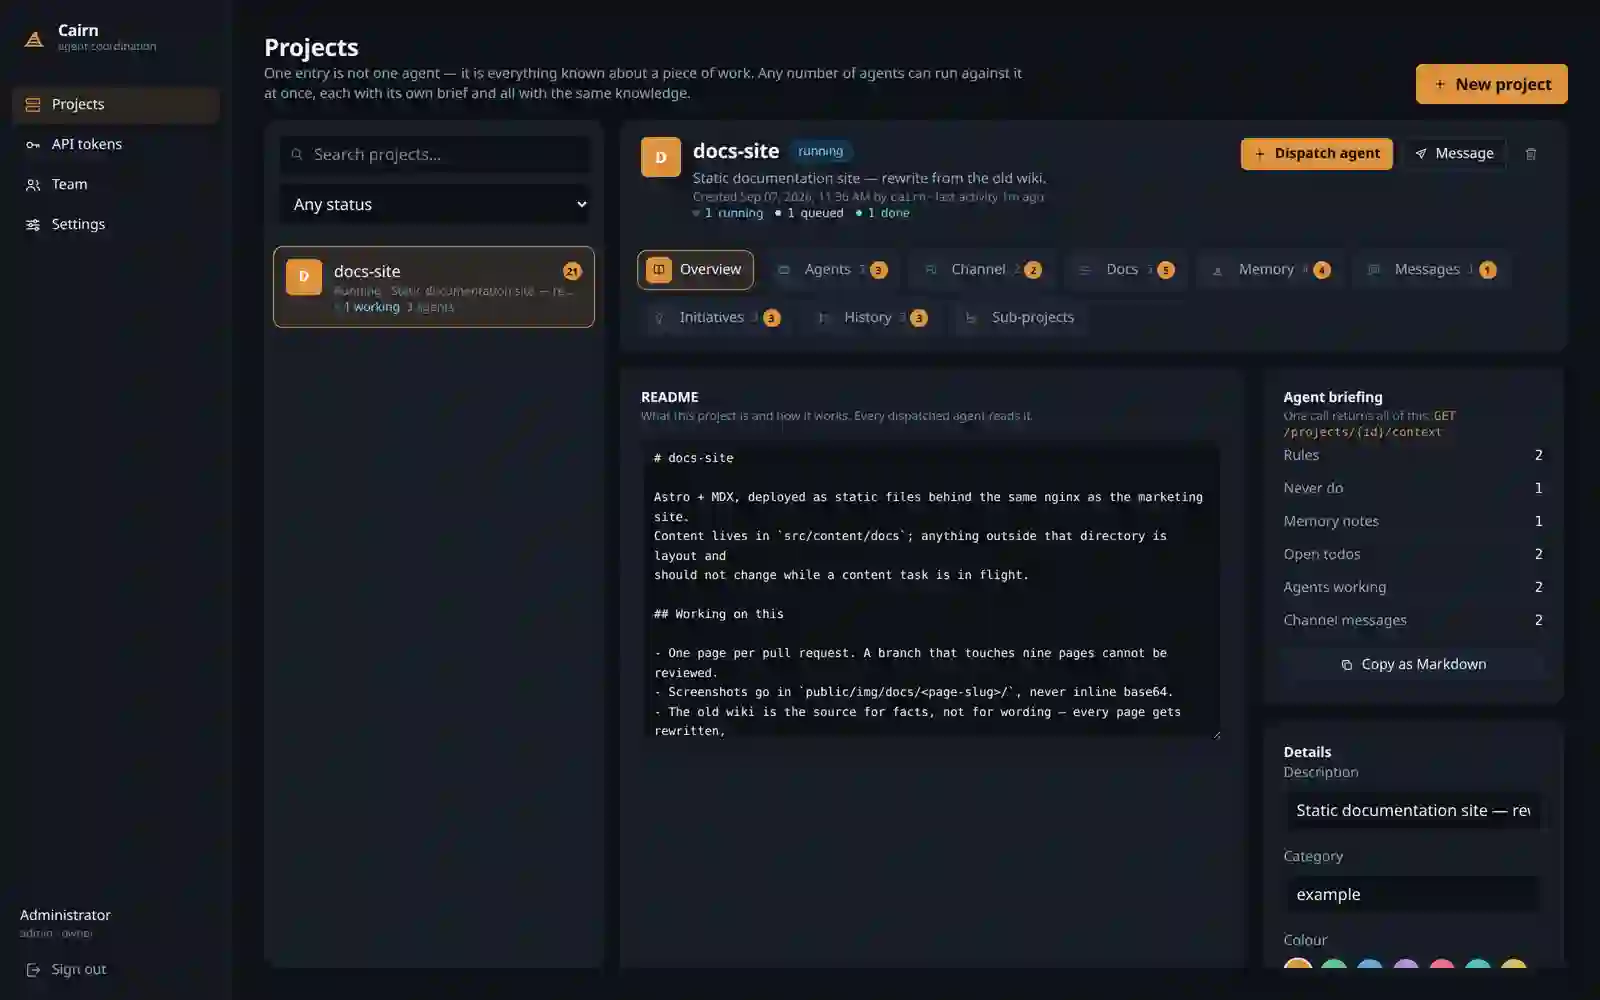
Cairn est un panneau auto-hébergé où la connaissance d'un projet survit aux agents IA qui y travaillent. C'est un journal de coordination, pas un runner : un agent lit le briefing, fait sa part et rapporte le résultat, pour que vous n'expliquiez pas la même chose au suivant depuis zéro. Pour les équipes qui lancent plusieurs agents sur le même code et en ont assez que la mémoire du projet meure avec la session.
Introduction
Quand plusieurs agents IA travaillent sur un seul repo, la connaissance du projet a la vilaine habitude de mourir avec la session qui s'est terminée. Le premier agent a appris les dépendances cachées, a découvert quelle partie du code est fragile, et a établi comment on déploie ici. Puis la session s'éteint et cette connaissance disparaît. À l'agent suivant vous expliquez la même chose depuis le début, et à celui d'après, et encore une fois, jusqu'à devenir le goulot d'étranglement de la connaissance de votre propre projet.
Ce n'est pas un problème de puissance de calcul ni de modèle. Aucun agent plus puissant ne le corrige, car c'est un problème de mémoire entre les sessions, pas au sein d'une seule. Cairn vise exactement cet endroit : il garde le briefing et l'historique des décisions en un seul endroit qui ne disparaît pas quand un agent termine son travail. Tout le reste de cette étude de cas raconte pourquoi c'est délibérément un journal, et non un énième orchestrateur.
La connaissance qui meurt avec la session
Une session d'agent est par nature éphémère. Elle rassemble du contexte, construit son travail dessus, puis se termine et tout ce contexte s'évapore. Avec un seul agent, ce n'est pas un problème : c'est vous qui vous en souvenez. Avec cinq qui entrent dans le même repo l'un après l'autre ou en parallèle, chacun part de zéro et chacun redécouvre les mêmes mines. La même migration fragile, le même déploiement non évident, la même dépendance qui n'explose que dans un certain ordre.
Le réflexe naturel est de l'écrire dans le README ou de le coller dans le prompt. Sauf qu'un README vieillit vite, et qu'un prompt meurt avec la fenêtre de chat. Ce qu'il fallait, c'était un endroit qui grandit avec le projet et survit aux sessions individuelles : quelque chose qu'un agent consulte pour du contexte à l'entrée et auquel il ajoute ce qu'il a fait à la sortie.
Cairn n'est délibérément pas un runner. Il ne lance pas d'agents, ne gère pas leurs processus et n'essaie pas d'être leur environnement. C'est un journal de coordination : un endroit qu'un agent consulte pour du contexte et où il réécrit ce qu'il a fait. Cette limite est toute sa force.
Un journal, pas un runner
Il aurait été facile d'en faire un énième orchestrateur qui lance lui-même les agents et tente de les diriger. Nous y avons renoncé exprès, car les runners ont un destin prévisible : ils s'intègrent en profondeur dans votre environnement, supposent de plus en plus de choses sur lui, et deviennent vite une chose qui a elle-même besoin d'entretien. Au lieu de donner de la mémoire, ils prennent du temps.
Un journal de coordination, c'est l'inverse : simple, passif et sans gêner personne. L'agent vit toujours là où il vit d'habitude, dans votre terminal ou votre pipeline, fait son travail dans son propre environnement, et Cairn lui donne juste de la mémoire et un endroit pour rapporter. Il n'y a ici aucune magie d'orchestration qui marche en démo et se disloque sur un vrai projet, parce qu'il n'y a pas d'orchestration du tout.
Ce qu'il garde, et ce qu'il ne garde délibérément pas
| Rôle | Cairn le fait | Cairn ne le fait pas |
|---|---|---|
| Contexte | garde le briefing et l'historique des décisions | ne devine pas le contexte à votre place |
| Coordination | un journal d'entrées par projet, dans l'ordre | ne lance ni ne gère les processus des agents |
| Hébergement | vous l'hébergez vous-même, les données restent vôtres | n'envoie pas votre code dans le cloud d'autrui |
| Visibilité | un seul endroit pour ce qui est fait et ouvert | ne remplace ni votre repo ni la CI |
La boucle briefing, travail, rapport
Au cœur se trouve un journal de coordination par projet. Au lieu de garder la connaissance dans la tête d'un agent ou dans une session de chat, vous l'écrivez une fois comme briefing, et chaque agent suivant commence par le lire. Quand il termine, il ajoute sa propre entrée : ce qu'il a fait, quel est l'état, ce qui reste ouvert pour le suivant. Le journal grandit et devient la mémoire du projet, indépendante de la session qui se trouve être en vie.
vous créez un projet et le décrivez une fois : ce que c'est, où sont les limites, à quoi faire attention.
chaque nouvel agent part du même contexte, sans que vous le répétiez à la main.
il fait sa tâche dans son propre environnement, car Cairn ne le lance ni ne le contraint.
il ajoute le résultat au journal : ce qu'il a changé, ce qui marche, ce qui reste à faire.
l'agent d'après lit le briefing et tous les rapports et entre dans le travail avec l'image complète.
L'essentiel, c'est qu'une entrée n'est pas du texte libre mais une courte structure avec un état et une liste de ce qui est ouvert pour le suivant. Cela permet de lire le journal aussi vite pour une machine que pour un humain, et l'agent suivant n'a pas à deviner où le tour précédent s'est arrêté.
Une échelle qui grandit avec le projet
La différence ne devient visible que sur la distance. Sans mémoire partagée, le coût d'intégration de chaque nouvel agent augmente, parce qu'à chaque fois vous expliquez à la main un historique de projet toujours plus long. Avec Cairn, ce coût est plat : le premier agent et le dixième lisent la même source, ils entrent donc dans le travail avec la même image, quel que soit leur rang dans l'ordre.
Temps d'intégration de l'agent suivant (indicatif, minutes)
C'est toute la différence entre une équipe qui met à l'échelle le nombre d'agents et une équipe qui se noie dans son propre onboarding. Une mémoire qui survit aux sessions transforme la connaissance du projet, de quelque chose qu'il faut reconstruire à chaque fois, en quelque chose qui est simplement là.
La couche de mémoire silencieuse
Les meilleurs outils ne sont pas ceux qui font le plus. Ce sont ceux qui font une seule chose et s'écartent du chemin.
Une équipe qui lance plusieurs agents sur le même code cesse d'être le goulot d'étranglement de sa propre connaissance. Le briefing, vous l'écrivez une fois, pas à chaque nouvelle fenêtre de chat. L'agent qui arrive en troisième en sait autant que le premier, parce qu'il lit la même chose. Cairn n'est pas spectaculaire et n'essaie pas de l'être : c'est la couche de mémoire silencieuse qui manquait jusqu'ici entre les sessions.
Gardez le briefing court et dur : les limites du projet, les points fragiles, la façon de déployer. Le reste, les agents l'ajoutent dans leurs rapports. Un briefing qui essaie de tout décrire vieillit aussi vite que le README qu'il devait remplacer.
Parce que vous l'hébergez vous-même, ni le code ni l'historique des décisions ne partent vers le cloud d'autrui. La mémoire du projet reste là où est le projet : chez vous. C'est une couche discrète, mais une fois que vous commencez à lancer des agents en série, il est difficile de revenir en arrière sans elle.
Plus de projets
D'autres réalisations de la même catégorie - découvrez comment nous abordons des défis similaires.
Vous avez un projet similaire ?
Contactez-nous - le devis est gratuit et arrive sous une heure.