
Pharos
Surveillance de l'uptime, page de statut publique et gestion des incidents dans un seul binaire (Go + SQLite embarqué), mis en place d'une seule commande. Deux choses qui le distinguent : des opérations d'incident qui vivent dans Discord et un uptime qui n'arrondit pas en sa faveur. Code ouvert, auto-hébergé.
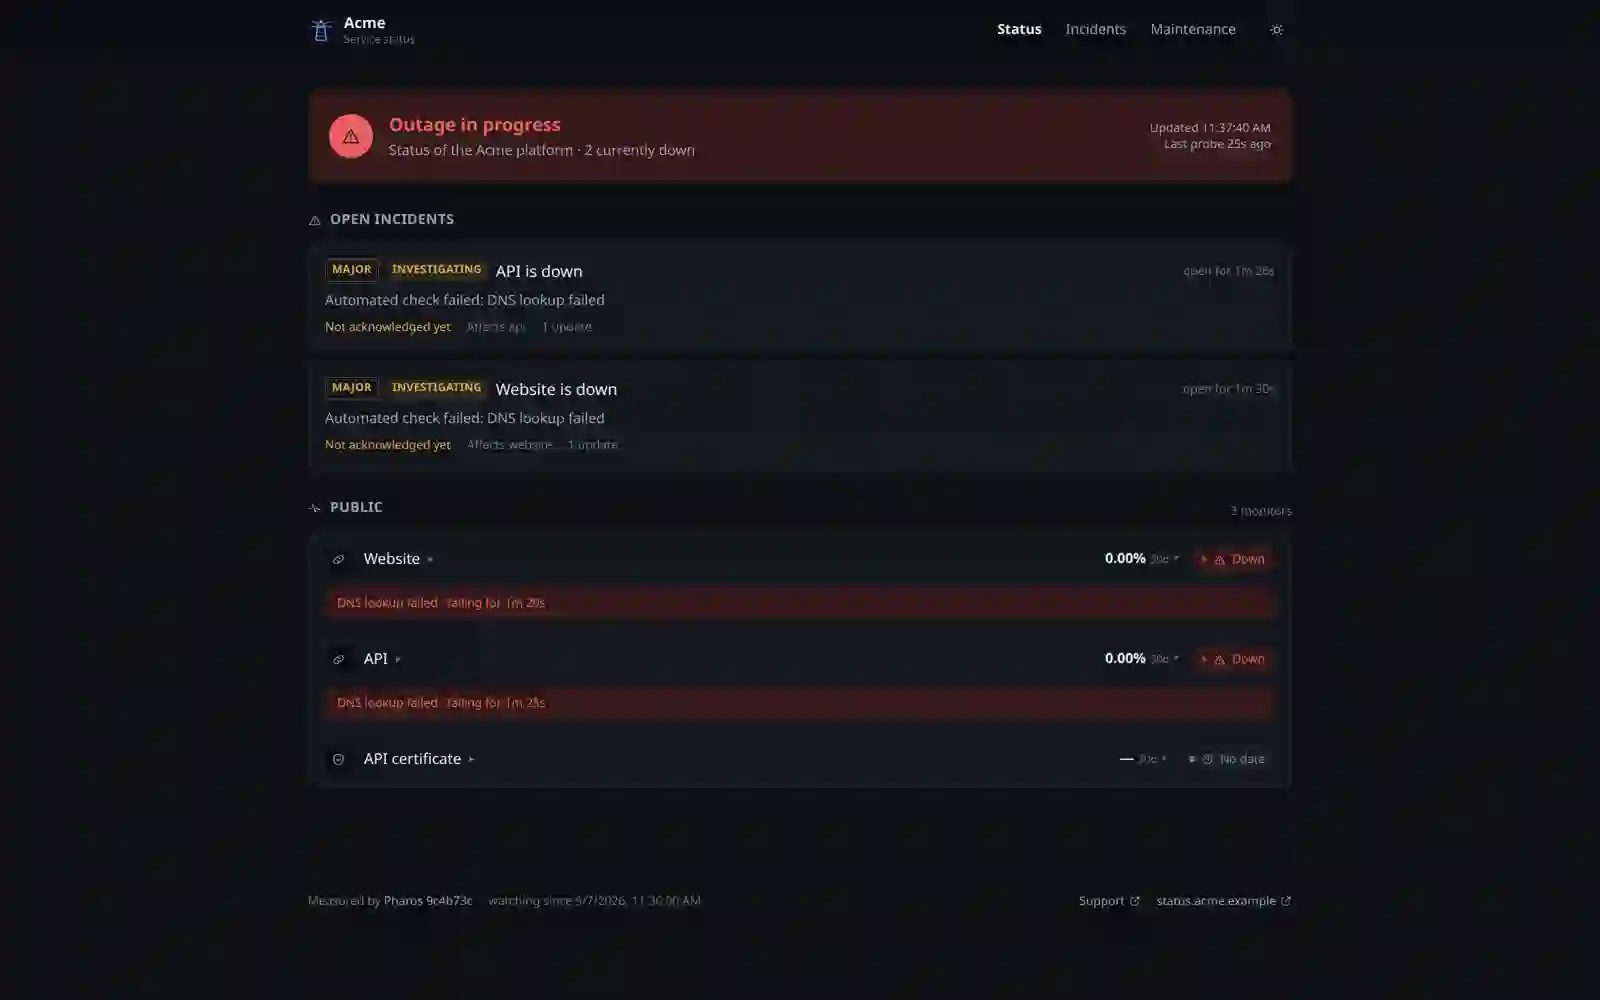
Pharos, c'est du monitoring d'uptime, une page de statut publique et la gestion des incidents réunis dans un seul binaire Go avec SQLite embarqué. Vous le lancez d'une seule commande, vous l'hébergez chez vous, et l'uptime n'arrondit pas à son propre avantage : le temps sans observation n'est pas "disponible", mais "inconnu". Vous gérez les incidents depuis Discord, le code est ouvert, et le chiffre sur la page de statut signifie exactement ce qu'il dit.
Introduction
Les pages de statut ont un vilain trait : presque toutes mentent à leur propre avantage. Quand une sonde cesse d'interroger un service, parce que le monitoring lui-même est tombé ou que la période de rétention est écoulée, la plupart des outils ne comptent tout simplement pas ce trou dans les statistiques. Le résultat est un graphique qui montre 100 pour cent de disponibilité sur une fenêtre où personne n'a rien mesuré. Ajoutez à cela les fenêtres de maintenance qui, comme par magie, n'entament jamais la barre, et vous voilà soudain avec un panneau qui a fière allure et ne signifie rien.
Nous avons construit Pharos dans l'autre sens. C'est un outil que vous montez d'une seule commande, que vous gardez sur votre propre serveur et auquel on peut réellement se fier, car lorsqu'il ne sait pas, il le dit. Ce n'est pas encore un tableau de bord cloud avec un abonnement et la rétention de quelqu'un d'autre, mais un seul fichier que vous copiez à côté du reste de vos services et que vous lancez. Tout le reste de cette étude de cas raconte comment une seule décision dans la formule de calcul de la disponibilité change le caractère du produit tout entier.
Le silence n'est pas la disponibilité
Le monitoring classique connaît deux états : le service fonctionne ou il ne fonctionne pas. C'est commode jusqu'à ce que vous demandiez ce qui se passe quand le monitoring ne regarde pas du tout. Car alors l'outil doit faire quelque chose de ce temps, et le choix par défaut tombe presque toujours dans le même piège : il traite le silence comme un succès et l'ajoute discrètement à la barre "up". C'est ainsi qu'apparaissent ces absurdes 100 pour cent pour un mois où, en réalité, la moitié des données n'existe pas.
Chez nous, chaque tranche de vie d'un service a trois états, pas deux. Disponible, panne et sans observation. Le troisième est tout l'enjeu : c'est le temps pendant lequel nous n'avons collecté aucune donnée, nous n'avons donc pas le droit d'affirmer que tout allait bien. Au lieu de l'ajouter au sommet, nous le montrons directement comme une part distincte de la fenêtre. Les fenêtres de maintenance sont signalées, mais elles n'effacent pas les pannes de l'historique, elles séparent seulement ce qui était planifié de ce qui était inattendu.
La plupart des pages de statut calculent la disponibilité comme le temps "up" divisé par le temps "up plus down". Pharos la calcule comme le temps "up" divisé par le temps réellement observé, et range la tranche non sondée à part comme "inconnu". C'est une différence d'une ligne dans la formule et toute la différence dans la confiance accordée au chiffre.
La même journée, deux compteurs
La même journée, passée par deux formules différentes, donne deux chiffres complètement différents. Et ce n'est pas de la cosmétique : c'est la différence entre un rapport auquel un client peut se fier et un rapport qui a seulement bonne allure en réunion. Nous avons choisi le moins flatteur, car c'est le seul qui signifie quelque chose.
La même journée, deux compteurs (pour cent de disponibilité)
Un seul fichier que vous montez d'une commande
Le plus grand problème pratique des outils de statut, c'est tout ce qu'il faut monter autour d'eux avant qu'ils n'affichent quoi que ce soit. Une base de données à part, une file, un worker, un panneau, un reverse proxy. Pharos va dans le sens inverse : tout le monitoring, l'historique, la page de statut et la gestion des incidents tiennent dans un seul exécutable Go statique, et les données sont conservées par un SQLite embarqué. Il n'y a pas de base de données séparée à monter et à surveiller, pas de runtime à installer. Vous copiez le binaire, vous le lancez, et vous travaillez.
Cette simplicité n'est pas une économie sur les fonctionnalités, mais une réduction délibérée de la surface de maintenance. Moins il y a de pièces mobiles, moins il y a de choses qui peuvent casser à trois heures du matin. Un déploiement, un port, un log à parcourir quand quelque chose tourne mal.
Stack
| Couche | Choix | Pourquoi ainsi |
|---|---|---|
| Cœur | Go, un seul exécutable statique | zéro dépendance runtime, vous copiez et vous lancez |
| Données | SQLite embarqué dans le binaire | pas de base séparée à monter et à surveiller |
| Sondes | HTTP et TCP en arrière-plan | des checks simples qui couvrent la plupart des services |
| Notifications | webhooks Discord | l'équipe est déjà là, pas besoin d'un outil de plus |
| Page de statut | servie depuis le même processus | un déploiement, un port, un log |
Des sondes en arrière-plan et un flux de résultats
Sous un chiffre honnête doit se trouver une source de données honnête. Pharos interroge vos services à intervalle fixe via HTTP et TCP, et enregistre chaque résultat isolé avec son temps de réponse et un horodatage. Nous ne moyennons rien à la volée et nous n'écrasons pas l'historique, car c'est précisément à partir de ce flux brut d'échantillons que les trois états sont ensuite construits. S'il n'y a pas d'échantillon pour un intervalle, cet intervalle est sans observation par définition, pas par défaut.
interroge vos services via HTTP et TCP à intervalle fixe et enregistre chaque résultat avec son temps de réponse.
chaque échantillon repose à part, avec son propre horodatage, au lieu d'être moyenné aussitôt.
construit l'historique à partir de trois états et ne traite jamais le silence comme un succès.
sert une page de statut publique avec un historique lisible, du genre qu'un client comprend sans traducteur.
quand l'état d'un service change, une notification arrive sur Discord, là où l'équipe travaille.
Remarquez deux choses dans cet extrait. Le temps sans observation est ignoré au dénominateur, pas ajouté au sommet. Et quand il n'y a eu aucune observation, la fonction renvoie NaN au lieu d'un faux 100 pour cent, car l'absence de données est l'absence de données, pas un succès.
Les incidents là où l'équipe est déjà
Le scénario classique de panne ressemble à ceci : quelque chose tombe, quelqu'un le remarque, et les allers-retours commencent entre le panneau de monitoring, la messagerie et la page de statut. Trois fenêtres, trois versions de la vérité, et de bonnes chances que le statut public s'écarte de ce que l'équipe sait réellement. Pharos ramène cela à un seul endroit. Vous ouvrez et menez un incident depuis Discord, et la page de statut publique n'est qu'un reflet de ce que l'équipe écrit de toute façon.
Il n'y a pas de deuxième outil à apprendre et aucun risque que le statut parte de son côté, car c'est la même réalité vue des deux côtés. L'ouverture, les mises à jour et la clôture se font là où vous êtes déjà, et la page se rafraîchit d'elle-même.
Un chiffre auquel on peut se fier
Le monitoring honnête n'est pas celui qui montre toujours du vert. C'est celui qui admet qu'il n'a pas regardé pendant un moment.
Ce qui en est sorti, c'est un outil que vous pouvez poser sur une petite machine à côté du reste de vos services et auquel vous pouvez ensuite arrêter de penser. Un fichier, une base embarquée, un port. Le chiffre sur la page de statut signifie exactement ce qu'il dit, et quand le monitoring ne sait pas quelque chose, il ne fait pas semblant de le savoir. Pour le client qui regarde cette page, c'est la différence entre la confiance et un panneau publicitaire.
Si votre page de statut affiche depuis des années un joli 99.99 pour cent, il vaut la peine de vérifier si les choses vont vraiment aussi bien ou si personne ne compte simplement le silence. Un compteur honnête montre presque toujours moins que celui auquel nous nous sommes habitués, et c'est justement pour cela qu'il vaut quelque chose.
Le code est ouvert, vous pouvez donc lire toute cette formule vous-même plutôt que de nous croire sur parole. C'est sans doute la chose la plus honnête qu'un outil de calcul honnête de la disponibilité puisse dire de lui-même.
Plus de projets
D'autres réalisations de la même catégorie - découvrez comment nous abordons des défis similaires.
Vous avez un projet similaire ?
Contactez-nous - le devis est gratuit et arrive sous une heure.
Comment nous comptons une uptime honnête
Le découpage en trois états semble mineur jusqu'à ce que vous le voyiez sur une fenêtre concrète. Prenez une journée où un service était disponible la plupart du temps, est tombé un instant, et pendant une tranche personne ne l'a sondé parce que la machine de monitoring s'est redémarrée d'elle-même. Un compteur naïf additionne le temps disponible et le temps non observé et recrache un pourcentage flatteur et élevé. Un compteur honnête montre moins et ajoute que pendant un moment il ne savait rien.
Ce dont une fenêtre est vraiment faite