
Cairn
Un pannello self-hosted in cui la conoscenza di un progetto sopravvive agli agenti che ci lavorano. Un log di coordinamento, non un runner: gli agenti leggono il briefing e riportano il risultato, e tu non spieghi la stessa cosa a ciascuno da capo. Per team che lanciano più agenti sullo stesso codice.
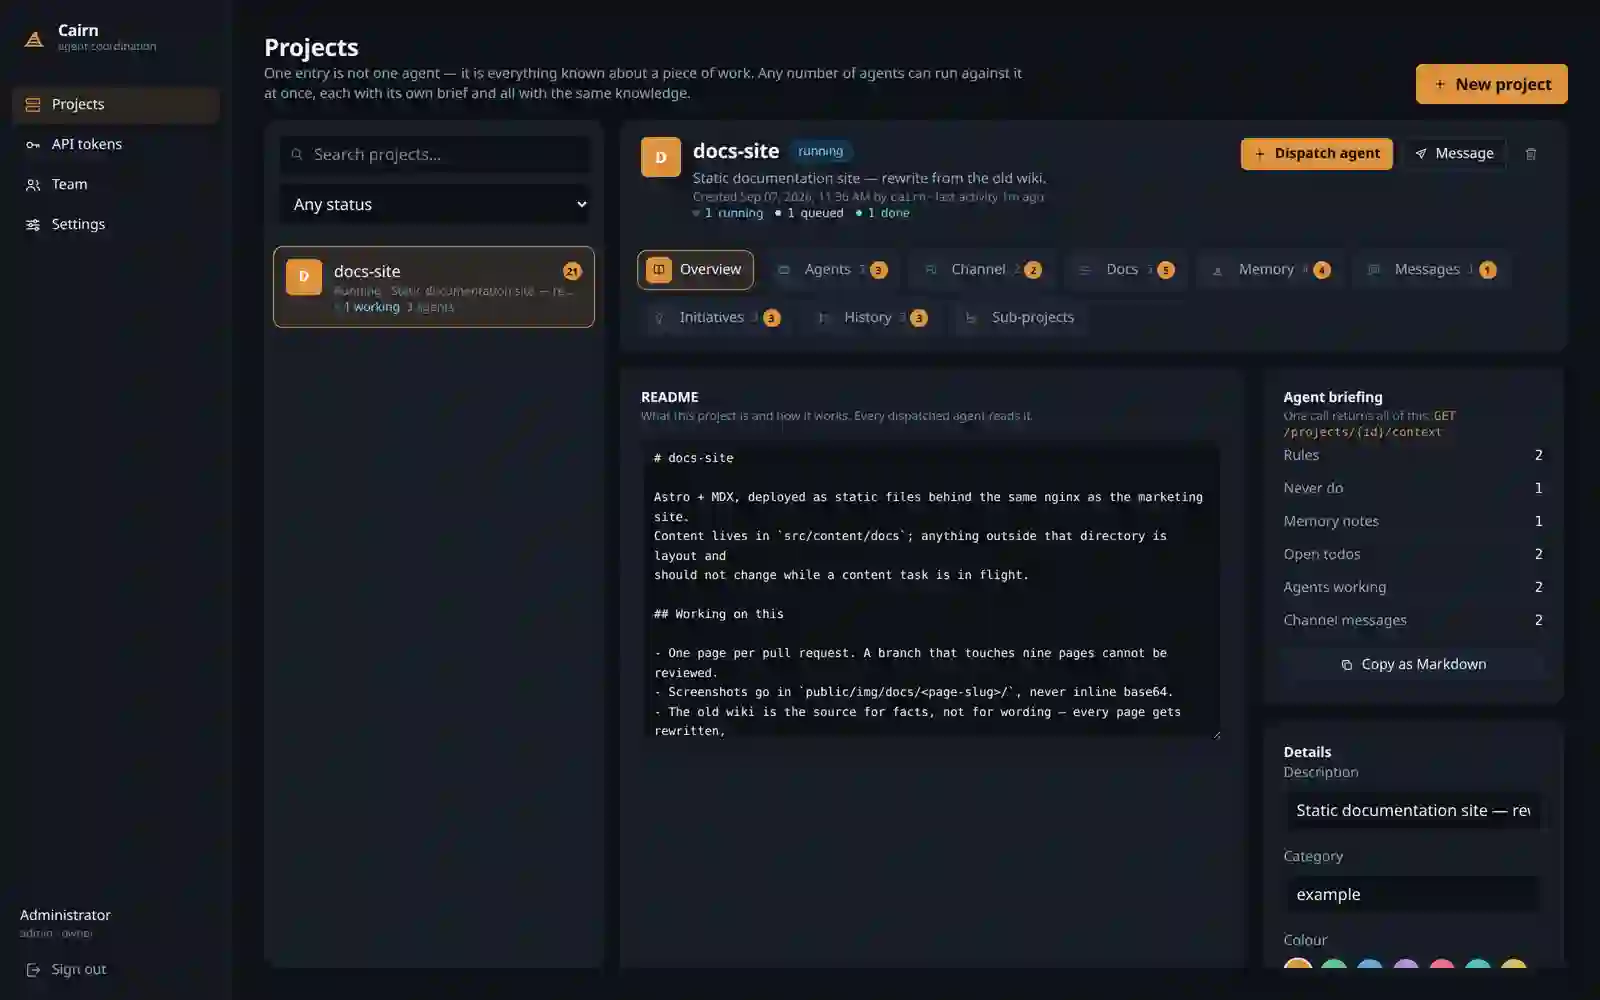
Cairn è un pannello self-hosted in cui la conoscenza di un progetto sopravvive agli agenti IA che ci lavorano. È un log di coordinamento, non un runner: un agente legge il briefing, fa la sua parte e riporta il risultato, così non spieghi la stessa cosa al successivo da zero. Per i team che lanciano più agenti sullo stesso codice e sono stanchi che la memoria del progetto muoia insieme alla sessione.
Introduzione
Quando più agenti IA lavorano su un solo repo, la conoscenza del progetto ha la brutta abitudine di morire con la sessione che è finita. Il primo agente ha imparato le dipendenze nascoste, ha scoperto quale parte del codice è fragile, e ha capito come si fa il deploy qui. Poi la sessione si spegne e quella conoscenza sparisce. All'agente successivo spieghi la stessa cosa da capo, e a quello dopo, e ancora una volta, finché non diventi il collo di bottiglia per la conoscenza del tuo stesso progetto.
Non è un problema di potenza di calcolo né di modello. Nessun agente più potente lo risolve, perché è un problema di memoria tra le sessioni, non all'interno di una sola. Cairn punta esattamente a quel punto: tiene il briefing e la cronologia delle decisioni in un unico posto che non svanisce quando un agente finisce il lavoro. Tutto il resto di questo case study racconta perché è deliberatamente un log e non l'ennesimo orchestratore.
Conoscenza che muore con la sessione
Una sessione di un agente è per natura effimera. Raccoglie contesto, ci costruisce sopra il suo lavoro, e poi finisce e tutto quel contesto evapora. Con un agente non è un problema: te ne ricordi tu. Con cinque che entrano nello stesso repo uno dopo l'altro o in parallelo, ognuno parte da zero e ognuno riscopre le stesse mine da capo. La stessa migrazione fragile, lo stesso deploy non ovvio, la stessa dipendenza che salta solo in un certo ordine.
Il riflesso naturale è scriverlo nel README o incollarlo nel prompt. Solo che un README invecchia in fretta, e un prompt muore con la finestra di chat. Serviva un posto che cresce con il progetto e sopravvive alle singole sessioni: qualcosa che un agente consulta per il contesto all'ingresso e a cui aggiunge ciò che ha fatto all'uscita.
Cairn deliberatamente non è un runner. Non avvia agenti, non gestisce i loro processi e non cerca di essere il loro ambiente. È un log di coordinamento: un posto che un agente consulta per il contesto e in cui riscrive ciò che ha fatto. Questo confine è tutta la sua forza.
Un log, non un runner
Sarebbe stato facile farne l'ennesimo orchestratore che avvia da sé gli agenti e cerca di dirigerli. Ci abbiamo rinunciato di proposito, perché i runner hanno un destino prevedibile: si agganciano in profondità al tuo ambiente, presumono sempre più cose su di esso, e diventano in fretta una cosa che ha bisogno di manutenzione a sua volta. Invece di dare memoria, tolgono tempo.
Un log di coordinamento è l'opposto: semplice, passivo e senza intralciare nessuno. L'agente continua a vivere dove vive di solito, nel tuo terminale o nella tua pipeline, fa il suo lavoro nel proprio ambiente, e Cairn gli dà solo memoria e un posto per riportare. Qui non c'è alcuna magia di orchestrazione che funziona in una demo e si sfalda su un progetto vero, perché non c'è orchestrazione affatto.
Cosa tiene, e cosa deliberatamente no
| Ruolo | Cairn lo fa | Cairn non lo fa |
|---|---|---|
| Contesto | tiene il briefing e la cronologia delle decisioni | non indovina il contesto al posto tuo |
| Coordinamento | un log di voci per progetto, in ordine | non avvia né gestisce i processi degli agenti |
| Hosting | lo ospiti da te, i dati restano tuoi | non manda il tuo codice nel cloud altrui |
| Visibilità | un unico posto per ciò che è fatto e aperto | non sostituisce né il tuo repo né la CI |
Il ciclo briefing, lavoro, report
Al centro c'è un log di coordinamento per progetto. Invece di tenere la conoscenza nella testa di un agente o in una sessione di chat, la scrivi una volta come briefing, e ogni agente successivo inizia leggendola. Quando finisce, aggiunge la propria voce: cosa ha fatto, qual è lo stato, cosa resta aperto per il successivo. Il log cresce e diventa la memoria del progetto, indipendente da quale sessione sia viva in quel momento.
crei un progetto e lo descrivi una volta: cos'è, dove sono i confini, a cosa fare attenzione.
ogni nuovo agente parte dallo stesso contesto, senza che tu lo ripeta a mano.
svolge il suo compito nel proprio ambiente, perché Cairn non lo avvia né lo limita.
aggiunge il risultato al log: cosa ha cambiato, cosa funziona, cosa resta da fare.
l'agente dopo legge il briefing più tutti i report ed entra nel lavoro con il quadro completo.
La chiave è che una voce non è testo libero ma una breve struttura con uno stato e un elenco di ciò che è aperto per il successivo. Così il log si legge alla stessa velocità per una macchina e per un umano, e l'agente successivo non deve indovinare dove si è fermato il turno precedente.
Una scala che cresce con il progetto
La differenza diventa visibile solo sulla distanza. Senza memoria condivisa il costo di inserire ogni nuovo agente cresce, perché ogni volta spieghi a mano una cronologia di progetto sempre più lunga. Con Cairn quel costo è piatto: il primo agente e il decimo leggono la stessa fonte, quindi entrano nel lavoro con lo stesso quadro, indipendentemente da che numero siano nell'ordine.
Tempo di inserimento dell'agente successivo (indicativo, minuti)
È tutta la differenza tra un team che scala il numero di agenti e un team che annega nel proprio onboarding. Una memoria che sopravvive alle sessioni trasforma la conoscenza del progetto, da qualcosa che va ricostruito ogni volta, in qualcosa che semplicemente c'è.
Lo strato di memoria silenzioso
Gli strumenti migliori non sono quelli che fanno di più. Sono quelli che fanno una cosa sola e si tolgono di mezzo.
Un team che lancia più agenti sullo stesso codice smette di essere il collo di bottiglia per la propria conoscenza. Il briefing lo scrivi una volta, non a ogni nuova finestra di chat. L'agente che arriva per terzo sa quanto il primo, perché legge la stessa cosa. Cairn non è vistoso e non cerca di esserlo: è lo strato di memoria silenzioso che prima mancava tra le sessioni.
Tieni il briefing corto e duro: i confini del progetto, le parti fragili, il modo in cui si fa il deploy. Il resto lo aggiungono gli agenti nei loro report. Un briefing che cerca di descrivere tutto invecchia alla stessa velocità del README che doveva sostituire.
Poiché lo ospiti da te, né il codice né la cronologia delle decisioni escono verso il cloud altrui. La memoria del progetto resta dove sta il progetto: da te. È uno strato defilato, ma una volta che inizi a lanciare agenti in serie, è difficile tornare indietro senza di esso.
Altri progetti
Altri lavori della stessa categoria - scopri come affrontiamo sfide simili.
Hai un progetto simile?
Contattaci - il preventivo è gratuito e arriva entro un'ora.