
Pharos
Monitoraggio dell'uptime, pagina di stato pubblica e gestione degli incidenti in un unico binario (Go + SQLite integrato), avviato con un solo comando. Due cose lo distinguono: le operazioni sugli incidenti che vivono in Discord e un uptime che non arrotonda a proprio favore. Codice aperto, self-hosting.
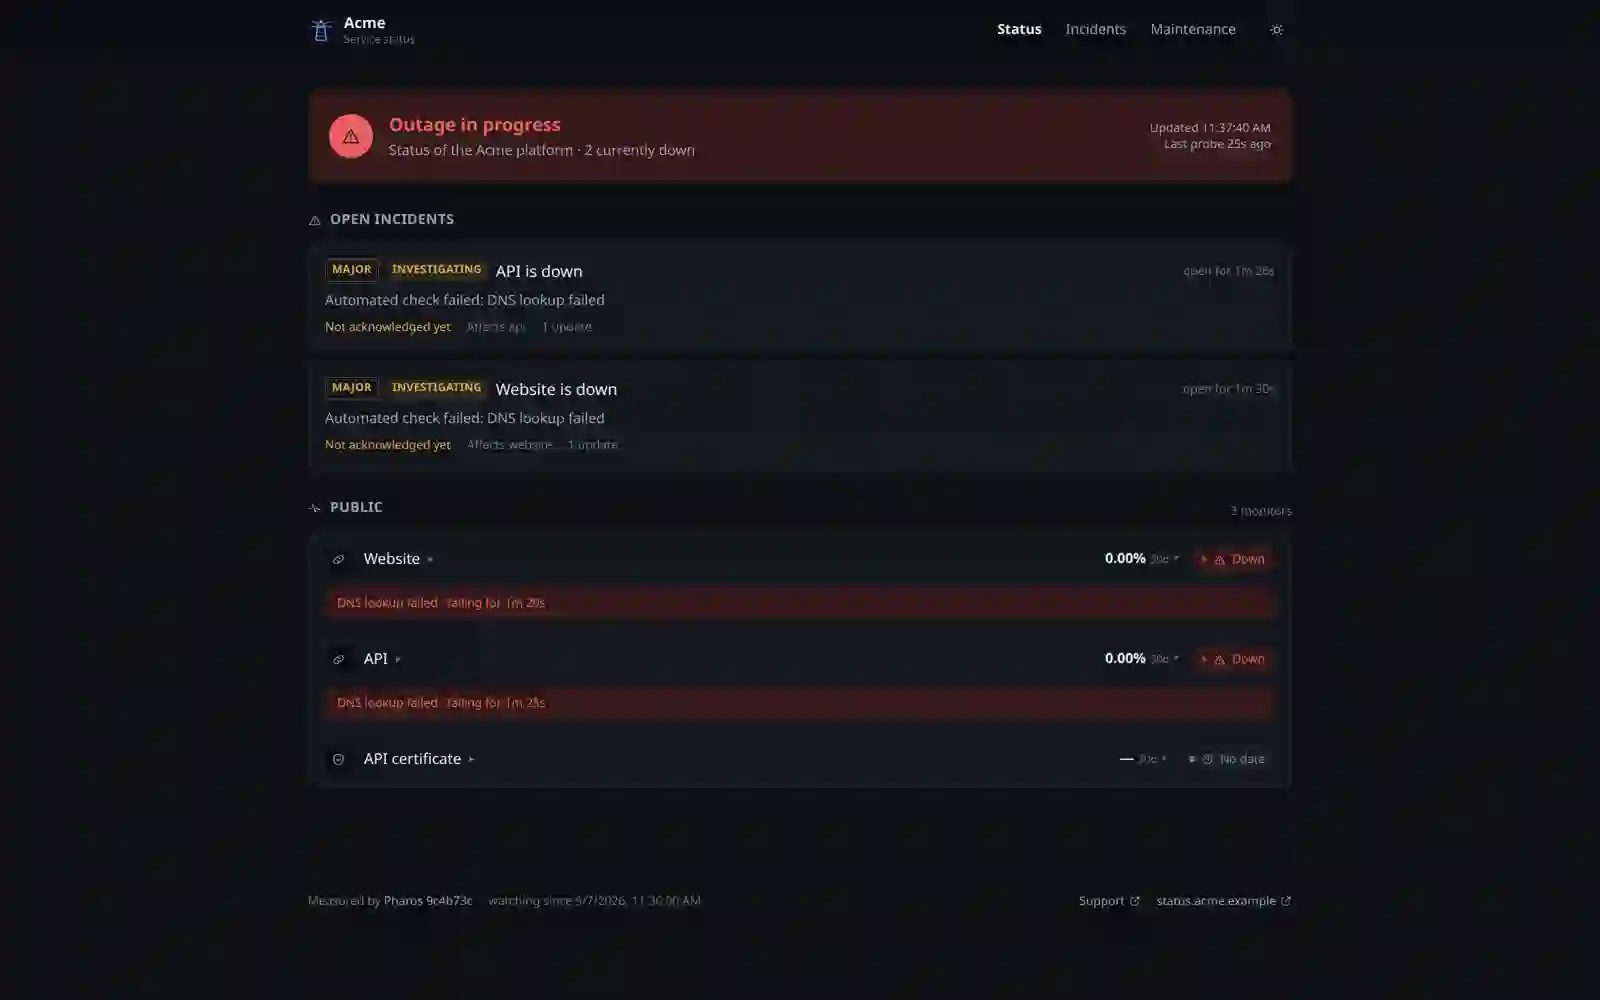
Pharos è monitoraggio dell'uptime, una pagina di stato pubblica e la gestione degli incidenti riuniti in un unico binario Go con SQLite incorporato. Lo avvii con un solo comando, lo ospiti da te, e l'uptime non arrotonda a proprio favore: il tempo senza osservazione non è "disponibile", ma "sconosciuto". Gli incidenti li gestisci da Discord, il codice è aperto, e il numero sulla pagina di stato significa esattamente ciò che dice.
Introduzione
Le pagine di stato hanno una brutta caratteristica: quasi tutte mentono a proprio favore. Quando una sonda smette di interrogare un servizio, perché il monitoraggio stesso è andato giù o è finito il periodo di conservazione, la maggior parte degli strumenti semplicemente non conta quel buco nelle statistiche. Il risultato è un grafico che mostra il 100 per cento di disponibilità su una finestra in cui nessuno ha misurato nulla. A questo si aggiungono le finestre di manutenzione che magicamente non intaccano mai la barra, e all'improvviso hai un pannello che sembra ottimo e non significa nulla.
Pharos lo abbiamo costruito al contrario. È uno strumento che metti in piedi con un solo comando, tieni sul tuo server e a cui si può davvero credere, perché quando non sa, lo dice. Non è l'ennesima dashboard cloud con abbonamento e conservazione altrui, ma un solo file che copi accanto al resto dei tuoi servizi e avvii. Tutto il resto di questo case study racconta come una sola decisione nella formula di calcolo della disponibilità cambi il carattere dell'intero prodotto.
Il silenzio non è disponibilità
Il monitoraggio classico conosce due stati: il servizio funziona o non funziona. È comodo finché non chiedi cosa succede quando il monitoraggio non guarda affatto. Perché allora lo strumento deve fare qualcosa con quel tempo, e la scelta predefinita cade quasi sempre nella stessa trappola: tratta il silenzio come un successo e lo somma di nascosto alla barra "up". È così che nascono quegli assurdi 100 per cento per un mese in cui in realtà metà dei dati non esiste.
Da noi ogni tratto di vita di un servizio ha tre stati, non due. Disponibile, guasto e senza osservazione. Il terzo è tutto il punto: è il tempo in cui non abbiamo raccolto dati, quindi non abbiamo il diritto di sostenere che andasse tutto bene. Invece di sommarlo verso l'alto, lo mostriamo direttamente come una parte distinta della finestra. Le finestre di manutenzione vengono contrassegnate, ma non cancellano i guasti dalla cronologia, separano soltanto ciò che era pianificato da ciò che era inatteso.
La maggior parte delle pagine di stato calcola la disponibilità come tempo "up" diviso per il tempo "up più down". Pharos la calcola come tempo "up" diviso per il tempo realmente osservato, e mette il tratto non sondato a parte come "sconosciuto". È una differenza di una riga nella formula e tutta la differenza nella fiducia riposta nel numero.
Come contiamo un uptime onesto
La suddivisione in tre stati sembra un dettaglio finché non la vedi su una finestra concreta. Prendi una giornata in cui un servizio è stato disponibile per la maggior parte del tempo, è caduto per un momento, e per un tratto nessuno lo ha sondato perché la macchina di monitoraggio si è riavviata da sola. Un contatore ingenuo somma il tempo disponibile con quello non osservato e sputa fuori una percentuale alta e vistosa. Un contatore onesto mostra meno e aggiunge che per un po' non sapeva nulla.
Di cosa è fatta davvero una finestra
La stessa giornata, due contatori
La stessa giornata, fatta passare per due formule diverse, dà due numeri completamente diversi. E non è cosmesi: è la differenza tra un report di cui un cliente può fidarsi e un report che sembra solo buono in riunione. Abbiamo scelto quello meno vistoso, perché è l'unico che significa qualcosa.
La stessa giornata, due contatori (per cento di disponibilità)
Un solo file che metti in piedi con un comando
Il più grande problema pratico degli strumenti di stato è quanto bisogna mettere in piedi attorno a loro prima che mostrino qualcosa. Un database a parte, una coda, un worker, un pannello, un reverse proxy. Pharos va nella direzione opposta: tutto il monitoraggio, la cronologia, la pagina di stato e la gestione degli incidenti stanno in un unico eseguibile Go statico, e i dati li tiene un SQLite incorporato. Non c'è un database separato da mettere in piedi e sorvegliare, nessun runtime da installare. Copi il binario, lo avvii, e lavori.
Questa semplicità non è un risparmio sulle funzioni, ma un taglio deliberato della superficie di manutenzione. Meno parti mobili ci sono, meno cose possono rompersi alle tre di notte. Un deploy, una porta, un log da leggere quando qualcosa va storto.
Stack
| Livello | Scelta | Perché così |
|---|---|---|
| Nucleo | Go, un unico eseguibile statico | zero dipendenze runtime, copi e avvii |
| Dati | SQLite incorporato nel binario | nessun database separato da mettere in piedi e sorvegliare |
| Sonde | HTTP e TCP in background | check semplici che coprono la maggior parte dei servizi |
| Notifiche | webhook Discord | il team è già lì, non serve un altro strumento |
| Pagina di stato | servita dallo stesso processo | un deploy, una porta, un log |
Sonde in background e un flusso di risultati
Sotto un numero onesto deve esserci una fonte di dati onesta. Pharos interroga i tuoi servizi a intervallo fisso via HTTP e TCP, e registra ogni singolo risultato insieme al suo tempo di risposta e a un timestamp. Non facciamo medie al volo e non sovrascriviamo la cronologia, perché è proprio da questo flusso grezzo di campioni che vengono poi costruiti i tre stati. Se non c'è un campione per un dato intervallo, quell'intervallo è senza osservazione per definizione, non per impostazione predefinita.
interroga i tuoi servizi via HTTP e TCP a intervallo fisso e registra ogni risultato con il suo tempo di risposta.
ogni campione sta a parte, con il proprio timestamp, invece di essere subito mediato via.
costruisce la cronologia da tre stati e non tratta mai il silenzio come un successo.
serve una pagina di stato pubblica con una cronologia leggibile, del tipo che un cliente capisce senza traduttore.
quando lo stato di un servizio cambia, una notifica arriva su Discord, proprio dove lavora il team.
Nota due cose in questo frammento. Il tempo senza osservazione viene escluso al denominatore, non sommato verso l'alto. E quando non c'è stata alcuna osservazione, la funzione restituisce NaN invece di un falso 100 per cento, perché l'assenza di dati è assenza di dati, non un successo.
Incidenti dove il team è già
Il classico scenario di guasto è così: qualcosa cade, qualcuno se ne accorge, e comincia il saltare tra il pannello di monitoraggio, la chat e la pagina di stato. Tre finestre, tre versioni della verità, e buone probabilità che lo stato pubblico si allontani da ciò che il team sa davvero. Pharos riduce tutto a un solo posto. Un incidente lo apri e lo gestisci da Discord, e la pagina di stato pubblica è solo un riflesso di ciò che il team scrive comunque.
Non c'è un secondo strumento da imparare e nessun rischio che lo stato vada per la sua strada, perché è la stessa realtà vista da due lati. Apertura, aggiornamenti e chiusura li sbrighi dove già siete, e la pagina si aggiorna da sola.
Un numero a cui si può credere
Il monitoraggio onesto non è quello che mostra sempre verde. È quello che ammette di non aver guardato per un momento.
Ne è uscito uno strumento che puoi mettere su una piccola macchina accanto al resto dei tuoi servizi e a cui poi puoi smettere di pensare. Un file, un database incorporato, una porta. Il numero sulla pagina di stato significa esattamente ciò che dice, e quando il monitoraggio non sa qualcosa, non fa finta di saperlo. Per il cliente che guarda quella pagina, è la differenza tra la fiducia e un cartellone pubblicitario.
Se la tua pagina di stato mostra da anni un pulito 99.99 per cento, vale la pena verificare se le cose vanno davvero così bene o se semplicemente nessuno conta il silenzio. Un contatore onesto mostra quasi sempre meno di quello a cui ci siamo abituati, ed è proprio per questo che vale qualcosa.
Il codice è aperto, quindi puoi leggere tutta questa formula da solo invece di crederci sulla parola. È probabilmente la cosa più onesta che uno strumento per contare onestamente la disponibilità possa dire di sé.
Altri progetti
Altri lavori della stessa categoria - scopri come affrontiamo sfide simili.
Hai un progetto simile?
Contattaci - il preventivo è gratuito e arriva entro un'ora.