
Pharos
Мониторинг аптайма, публичная страница статуса и обработка инцидентов в одном бинарнике (Go + встроенный SQLite), поднимается одной командой. Две вещи выделяют его: операции по инцидентам, живущие в Discord, и аптайм, который не округляет в свою пользу. Открытый код, self-hosting.
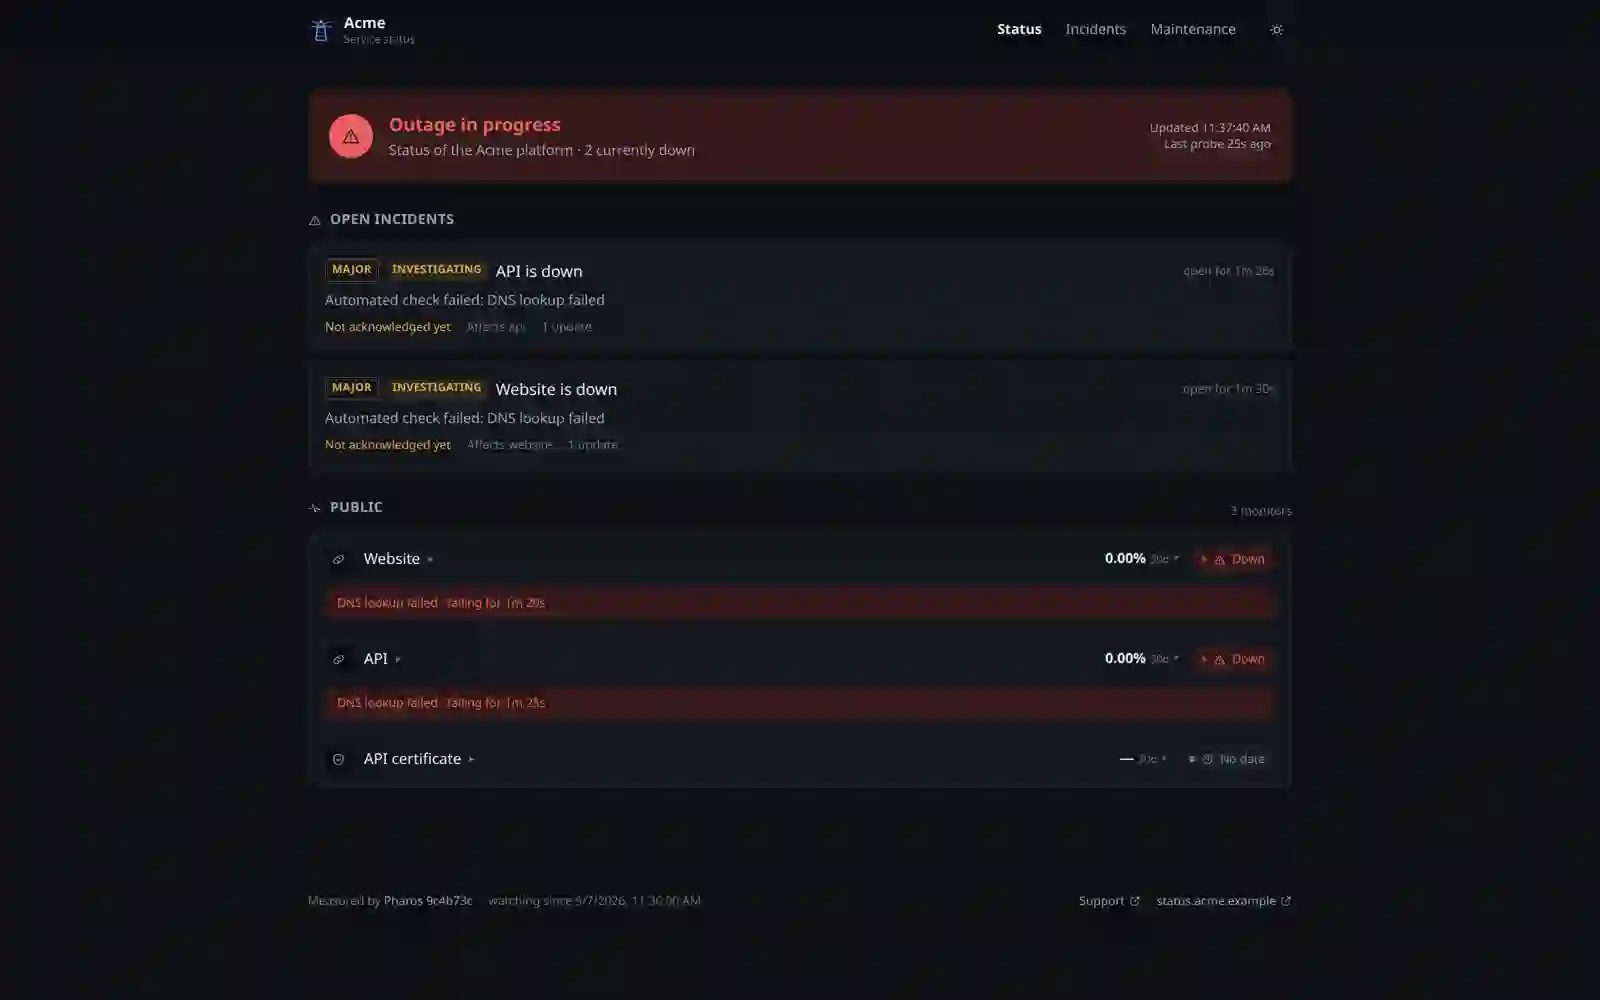
Pharos - это мониторинг аптайма, публичная страница статуса и работа с инцидентами, собранные в одном бинарнике на Go со встроенным SQLite. Вы поднимаете его одной командой, хостите у себя, и аптайм не округляется в свою пользу: время без наблюдения - это не "доступен", а "неизвестно". Инциденты вы ведёте из Discord, код открыт, а число на странице статуса значит ровно то, что говорит.
Введение
У страниц статуса есть одна уродливая черта: почти все они врут в свою пользу. Когда зонд перестаёт опрашивать сервис, потому что упал сам мониторинг или закончился срок хранения, большинство инструментов просто не засчитывают эту дыру в статистику. В результате график показывает 100 процентов доступности за период, в котором никто ничего не измерял. К этому добавляются окна обслуживания, которые волшебным образом никогда не портят столбик, и вдруг у вас есть панель, которая отлично выглядит и не значит ничего.
Pharos мы построили в обратную сторону. Это инструмент, который вы поднимаете одной командой, держите на собственном сервере и которому можно верить, потому что когда он не знает, он говорит, что не знает. Это не очередной облачный дашборд с подпиской и чужим хранением, а один файл, который вы копируете рядом с остальными сервисами и запускаете. Весь остальной этот кейс - рассказ о том, как одно решение в формуле подсчёта доступности меняет характер всего продукта.
Тишина - это не доступность
Классический мониторинг знает два состояния: сервис работает или не работает. Это удобно, пока вы не спросите, что происходит, когда мониторинг вообще не смотрит. Ведь тогда инструменту надо что-то сделать с этим временем, и выбор по умолчанию почти всегда попадает в одну и ту же ловушку: он трактует тишину как успех и тихо приписывает её к столбику "up". Так и рождаются эти нелепые 100 процентов за месяц, в котором на деле половины данных не существует.
У нас каждый отрезок жизни сервиса имеет три состояния, а не два. Доступен, сбой и без наблюдения. Третье - в этом вся суть: это время, в которое мы не собирали данные, поэтому не имеем права утверждать, что всё было хорошо. Вместо того чтобы приписывать его вверх, мы показываем его прямо как отдельный кусок периода. Окна обслуживания помечаются, но не стирают сбои из истории, а лишь отделяют запланированное от неожиданного.
Большинство страниц статуса считают доступность как время "up", делённое на время "up плюс down". Pharos считает её как время "up", делённое на реально наблюдаемое время, а неопрошенный отрезок кладёт отдельно как "неизвестно". Это разница в одну строку в формуле и вся разница в доверии к числу.
Как мы считаем честный аптайм
Разбиение на три состояния звучит мелочью, пока не увидите его на конкретном окне. Возьмите сутки, в которые сервис был доступен большую часть времени, на миг лёг, а какой-то отрезок его никто не опрашивал, потому что сама машина мониторинга перезагружалась. Наивный счётчик сложит доступное с ненаблюдаемым и выдаст эффектные, высокие проценты. Честный счётчик покажет меньше и добавит, что какое-то время он ничего не знал.
Из чего на самом деле состоит окно
Те же сутки, два счётчика
Те же сутки, пропущенные через две разные формулы, дают два совершенно разных числа. И это не косметика: это разница между отчётом, которому клиент может доверять, и отчётом, который лишь хорошо выглядит на встрече. Мы выбрали менее эффектный, потому что только он что-то значит.
Те же сутки, два счётчика (процент доступности)
Один файл, который вы поднимаете командой
Самая большая практическая проблема инструментов статуса - сколько всего нужно поднять вокруг них, прежде чем они хоть что-то покажут. Отдельная база, очередь, воркер, панель, реверс-прокси. Pharos идёт в обратную сторону: весь мониторинг, история, страница статуса и работа с инцидентами сидят в одном статическом исполняемом файле на Go, а данные держит встроенный SQLite. Нет отдельной базы, которую надо поднимать и стеречь, нет рантайма для установки. Копируете бинарник, запускаете, работаете.
Эта простота - не экономия на функциях, а осознанное урезание поверхности сопровождения. Чем меньше движущихся частей, тем меньше вещей, которые могут сломаться в три часа ночи. Один деплой, один порт, один лог для просмотра, когда что-то пойдёт не так.
Стек
| Слой | Выбор | Почему так |
|---|---|---|
| Ядро | Go, один статический исполняемый файл | ноль рантайм-зависимостей, копируете и запускаете |
| Данные | SQLite, встроенный в бинарник | нет отдельной базы, которую надо поднимать и стеречь |
| Зонды | HTTP и TCP в фоне | простые проверки, покрывающие большинство сервисов |
| Уведомления | вебхуки Discord | команда уже там, не нужен ещё один инструмент |
| Страница статуса | отдаётся из того же процесса | один деплой, один порт, один лог |
Зонды в фоне и поток результатов
Под честным числом должен лежать честный источник данных. Pharos опрашивает ваши сервисы с фиксированным интервалом по HTTP и TCP и записывает каждый отдельный результат вместе со временем отклика и меткой времени. Мы ничего не усредняем на лету и не перезаписываем историю, потому что именно из этого сырого потока проб потом и строятся три состояния. Если пробы для какого-то интервала нет, этот интервал без наблюдения по определению, а не по домыслу.
опрашивает ваши сервисы по HTTP и TCP с фиксированным интервалом и записывает каждый результат со временем отклика.
каждая проба лежит отдельно, со своей меткой времени, вместо того чтобы сразу быть усреднённой.
строит историю из трёх состояний и никогда не трактует тишину как успех.
выставляет публичную страницу статуса с понятной историей, такой, которую клиент понимает без переводчика.
когда состояние сервиса меняется, уведомление летит в Discord, прямо туда, где работает команда.
Обратите внимание на две вещи в этом фрагменте. Время без наблюдения пропускается в знаменателе, а не приписывается вверх. И когда наблюдения не было вовсе, функция возвращает NaN вместо фальшивых 100 процентов, потому что отсутствие данных - это отсутствие данных, а не успех.
Инциденты там, где команда уже есть
Классический сценарий аварии выглядит так: что-то падает, кто-то это видит, и начинается прыганье между панелью мониторинга, мессенджером и страницей статуса. Три окна, три версии правды, и большой шанс, что публичный статус разойдётся с тем, что команда знает на самом деле. Pharos сводит это к одному месту. Инцидент вы заводите и ведёте из Discord, а публичная страница статуса - лишь отражение того, что команда и так пишет.
Нет второго инструмента, который надо учить, и нет риска, что статус уйдёт в свою сторону, потому что это одна и та же реальность, видимая с двух сторон. Заведение, обновления и закрытие вы делаете там, где и так сидите, а страница обновляется сама.
Число, которому можно верить
Честный мониторинг - не тот, что всегда показывает зелёное. Это тот, что признаёт, что на миг не смотрел.
Получился инструмент, который вы можете поставить на маленькой машине рядом с остальными сервисами и о котором можно не думать. Один файл, встроенная база, один порт. Число на странице статуса значит ровно то, что говорит, а когда мониторинг чего-то не знает, он не притворяется, что знает. Для клиента, который смотрит на эту страницу, это разница между доверием и рекламным щитом.
Если ваша страница статуса годами показывает ровные 99.99 процента, стоит проверить, действительно ли всё так хорошо или просто никто не засчитывает тишину. Честный счётчик почти всегда покажет меньше, чем тот, к которому мы привыкли, и именно поэтому он чего-то стоит.
Код открыт, так что всю эту формулу вы можете прочитать сами, а не верить нам на слово. Это, пожалуй, самое честное, что инструмент для честного подсчёта доступности может сказать о себе.
Больше проектов
Другие работы из той же категории - посмотрите, как мы решаем похожие задачи.
Есть похожий проект?
Напишите нам - смета бесплатна и приходит в течение часа.