
Pharos
Monitoring uptime, publiczna strona statusu i obsługa incydentów w jednym binarium (Go + wbudowany SQLite), stawianym jednym poleceniem. Dwie rzeczy, które go wyróżniają: operacje incydentowe żyjące w Discordzie i uptime, który nie zaokrągla na swoją korzyść. Otwarty kod, self-hosting.
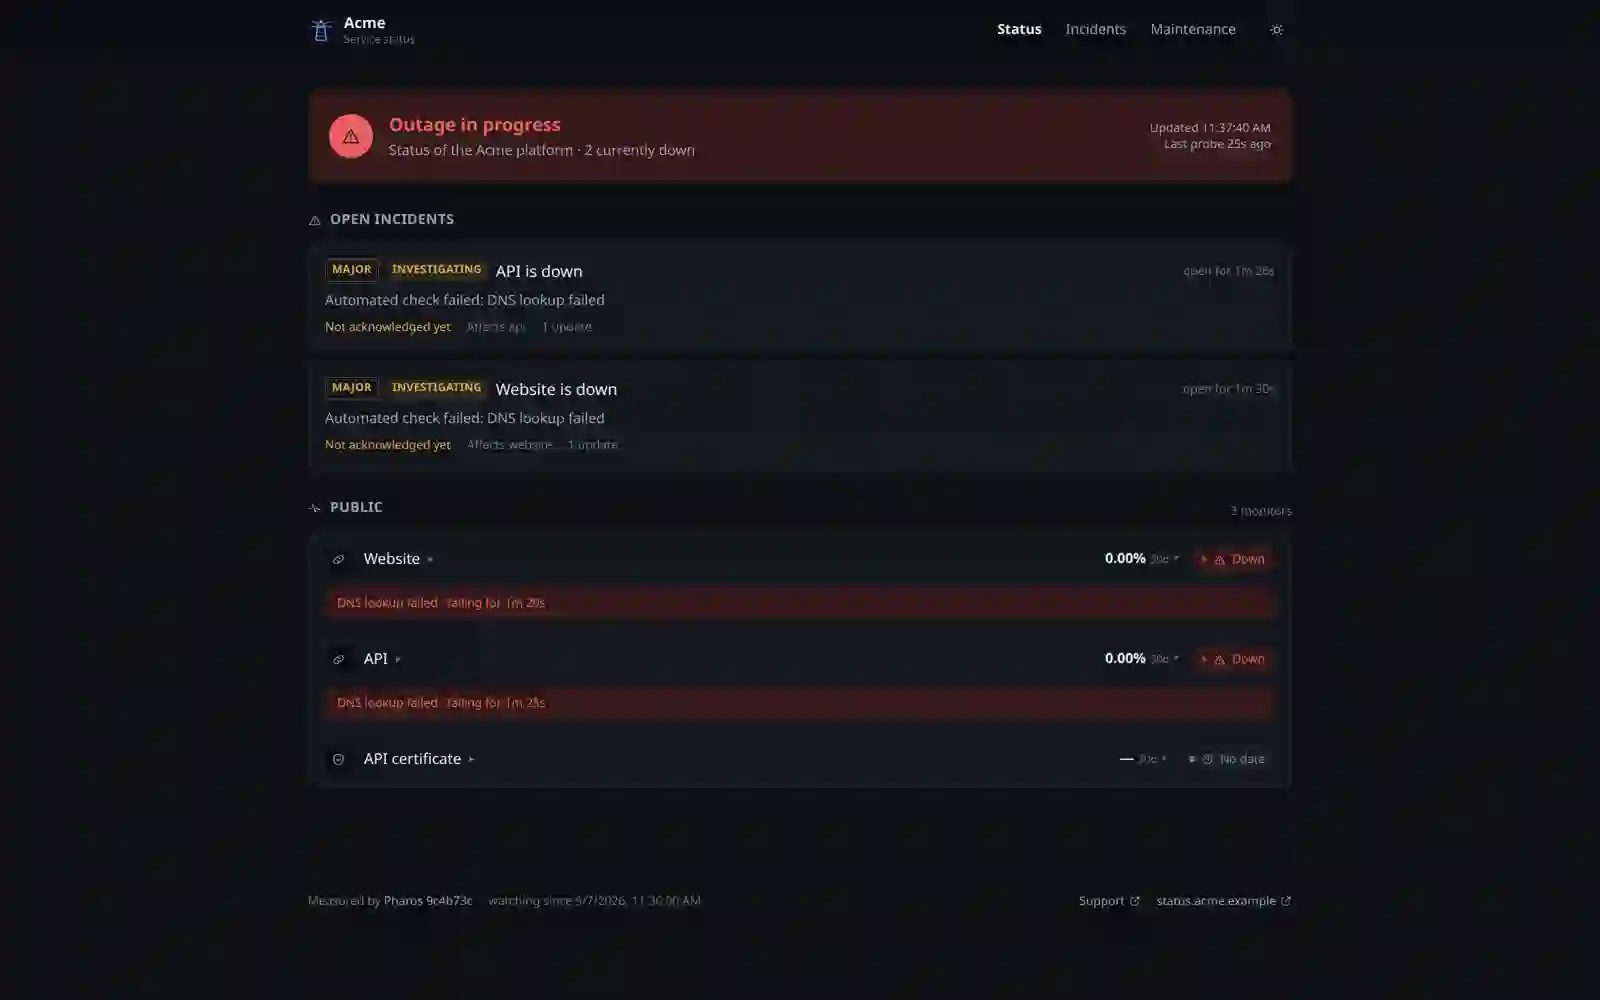
Pharos to monitoring uptime, publiczna strona statusu i obsługa incydentów spięte w jednym binarium na Go z wbudowanym SQLite. Stawiasz go jedną komendą, hostujesz u siebie, a uptime nie zaokrągla się na własną korzyść: czas bez obserwacji to nie "dostępny", tylko "nieznany". Incydenty prowadzisz z Discorda, kod jest otwarty, a liczba na stronie statusu znaczy dokładnie to, co mówi.
Wprowadzenie
Strony statusu mają jedną brzydką właściwość: prawie wszystkie kłamią na swoją korzyść. Kiedy sonda przestaje odpytywać usługę, bo padł sam monitoring albo skończył się okres retencji, większość narzędzi po prostu nie wlicza tej dziury do statystyki. Efekt jest taki, że wykres pokazuje 100 procent dostępności przez czas, w którym nikt niczego nie mierzył. Do tego dochodzą okna serwisowe, które magicznie nie psują słupka, i nagle masz panel, który wygląda świetnie i nie znaczy nic.
Pharos zbudowaliśmy w drugą stronę. To narzędzie, które stawiasz jednym poleceniem, trzymasz na własnym serwerze i któremu można wierzyć, bo kiedy nie wie, to mówi, że nie wie. Nie jest to kolejny chmurowy dashboard z abonamentem i cudzą retencją, tylko jeden plik, który kopiujesz obok reszty usług i uruchamiasz. Cała reszta tego case study to opowieść o tym, jak jedna decyzja w formule liczenia dostępności zmienia charakter całego produktu.
Cisza to nie dostępność
Klasyczny monitoring zna dwa stany: usługa działa albo nie działa. To wygodne, dopóki nie zapytasz, co się dzieje, gdy monitoring w ogóle nie patrzy. Bo wtedy narzędzie musi coś z tym czasem zrobić, a domyślny wybór prawie zawsze wpada w tę samą pułapkę: ciszę traktuje jak sukces i dolicza ją po cichu do słupka "up". Tak powstają te niedorzeczne 100 procent za miesiąc, w którym realnie połowa danych nie istnieje.
U nas każdy okres życia usługi ma trzy stany, nie dwa. Dostępny, awaria i bez obserwacji. Ten trzeci jest całą pointą: to czas, w którym nie zbieraliśmy danych, więc nie mamy prawa twierdzić, że było dobrze. Zamiast doliczać go do góry, pokazujemy go wprost jako osobny kawałek okresu. Okna serwisowe są oznaczane, ale nie kasują awarii z historii, tylko oddzielają to, co planowane, od tego, co niespodziewane.
Większość statusów liczy dostępność jako czas "up" podzielony przez czas "up plus down". Pharos liczy ją jako czas "up" podzielony przez czas realnie obserwowany, a okres bez sond kładzie osobno jako "nieznany". To jedna linijka różnicy w formule i cała różnica w zaufaniu do liczby.
Jak liczymy uczciwy uptime
Podział na trzy stany brzmi drobnie, dopóki nie zobaczysz go na konkretnym oknie. Weź dobę, w której usługa była dostępna przez większą część czasu, przez chwilę leżała, a przez kawałek nikt jej nie sondował, bo restartowała się sama maszyna monitorująca. Naiwny licznik zsumuje dostępne z nieobserwowanym i wyrzuci efektowne, wysokie procenty. Uczciwy licznik pokaże mniej i doda, że przez jakiś czas nic nie wiedział.
Z czego naprawdę składa się okno
Ta sama doba, dwa liczniki
Ta sama doba, przepuszczona przez dwie różne formuły, daje dwie zupełnie inne liczby. I to nie jest kosmetyka: to różnica między raportem, któremu klient może zaufać, a raportem, który tylko dobrze wygląda na spotkaniu. Wybraliśmy ten mniej efektowny, bo tylko on coś znaczy.
Ta sama doba, dwa liczniki (procent dostępności)
Jeden plik, który stawiasz komendą
Największym praktycznym problemem narzędzi do statusu jest to, ile trzeba wokół nich postawić, zanim cokolwiek zaczną pokazywać. Osobna baza, kolejka, worker, panel, reverse proxy. Pharos idzie w przeciwną stronę: cały monitoring, historia, strona statusu i obsługa incydentów siedzą w jednym statycznym pliku wykonywalnym na Go, a dane trzyma wbudowany SQLite. Nie ma osobnej bazy do postawienia i pilnowania, nie ma runtime do zainstalowania. Kopiujesz binarium, uruchamiasz, działasz.
Ta prostota nie jest oszczędzaniem na funkcjach, tylko świadomym cięciem powierzchni utrzymania. Im mniej ruchomych części, tym mniej rzeczy, które mogą się zepsuć o trzeciej w nocy. Jedno wdrożenie, jeden port, jeden log do przejrzenia, kiedy coś pójdzie nie tak.
Stos
| Warstwa | Wybór | Dlaczego tak |
|---|---|---|
| Rdzeń | Go, jeden statyczny plik wykonywalny | zero zależności runtime, kopiujesz i uruchamiasz |
| Dane | SQLite wbudowany w binarium | brak osobnej bazy do postawienia i pilnowania |
| Sondy | HTTP i TCP w tle | proste checki, które pokrywają większość usług |
| Powiadomienia | webhooki Discorda | zespół już tam jest, nie trzeba kolejnego narzędzia |
| Strona statusu | serwowana z tego samego procesu | jedno wdrożenie, jeden port, jeden log |
Sondy w tle i strumień wyników
Pod uczciwą liczbą musi leżeć uczciwe źródło danych. Pharos odpytuje twoje usługi w stałym interwale po HTTP i TCP, i zapisuje każdy pojedynczy wynik razem z czasem odpowiedzi i znacznikiem czasu. Nie uśredniamy niczego w locie i nie nadpisujemy historii, bo to właśnie z tego surowego strumienia próbek buduje się potem trzy stany. Jeśli próbki dla jakiegoś przedziału nie ma, ten przedział jest bez obserwacji z definicji, a nie z domysłu.
odpytuje twoje usługi po HTTP i TCP w stałym interwale i zapisuje każdy wynik z czasem odpowiedzi.
każda próbka leży osobno, z własnym znacznikiem czasu, zamiast być od razu uśredniana.
buduje historię z trzech stanów i nigdy nie traktuje ciszy jako sukcesu.
wystawia publiczną stronę statusu z czytelną historią, taką, którą klient rozumie bez tłumaczenia.
kiedy stan usługi się zmienia, leci powiadomienie na Discorda, od razu tam, gdzie pracuje zespół.
Zwróć uwagę na dwie rzeczy w tym kawałku. Czas bez obserwacji jest pomijany w mianowniku, a nie doliczany do góry. I kiedy nie było żadnej obserwacji, funkcja zwraca NaN zamiast fałszywego 100 procent, bo brak danych to brak danych, nie sukces.
Incydenty tam, gdzie już jest zespół
Klasyczny scenariusz awarii wygląda tak: coś pada, ktoś to widzi, i zaczyna się skakanie między panelem monitoringu, komunikatorem i stroną statusu. Trzy okna, trzy wersje prawdy, i duża szansa, że publiczny status rozjedzie się z tym, co zespół naprawdę wie. Pharos ścina to do jednego miejsca. Incydent zakładasz i prowadzisz z Discorda, a publiczna strona statusu jest tylko odbiciem tego, co zespół i tak już pisze.
Nie ma drugiego narzędzia do nauczenia i nie ma ryzyka, że status pójdzie w swoją stronę, bo to ta sama rzeczywistość widziana z dwóch stron. Zgłoszenie, aktualizacje i zamknięcie ogarniasz tam, gdzie i tak siedzicie, a strona odświeża się sama.
Liczba, której można wierzyć
Uczciwy monitoring nie jest ten, który zawsze pokazuje zielono. To ten, który przyznaje się, że przez chwilę nie patrzył.
Wyszło narzędzie, które możesz postawić na małej maszynie obok reszty usług i o którym nie musisz myśleć. Jeden plik, wbudowana baza, jeden port. Liczba na stronie statusu znaczy dokładnie to, co mówi, a kiedy monitoring czegoś nie wie, to nie udaje, że wie. Dla klienta, który tę stronę ogląda, to różnica między zaufaniem a ścianką reklamową.
Jeśli twoja strona statusu od lat pokazuje równiutkie 99.99 procent, warto sprawdzić, czy naprawdę jest tak dobrze, czy po prostu nikt nie wlicza ciszy. Uczciwy licznik prawie zawsze pokaże mniej niż ten, do którego przywykliśmy, i właśnie dlatego jest coś wart.
Kod jest otwarty, więc całą tę formułę możesz przeczytać samodzielnie, a nie wierzyć nam na słowo. To chyba najuczciwsza rzecz, jaką narzędzie do uczciwego liczenia dostępności może o sobie powiedzieć.
Więcej projektów
Inne realizacje z tej samej kategorii - zobacz, jak podchodzimy do podobnych wyzwań.
Masz podobny projekt?
Napisz do nas - wycena jest bezpłatna i wraca w godzinę.