Cairn
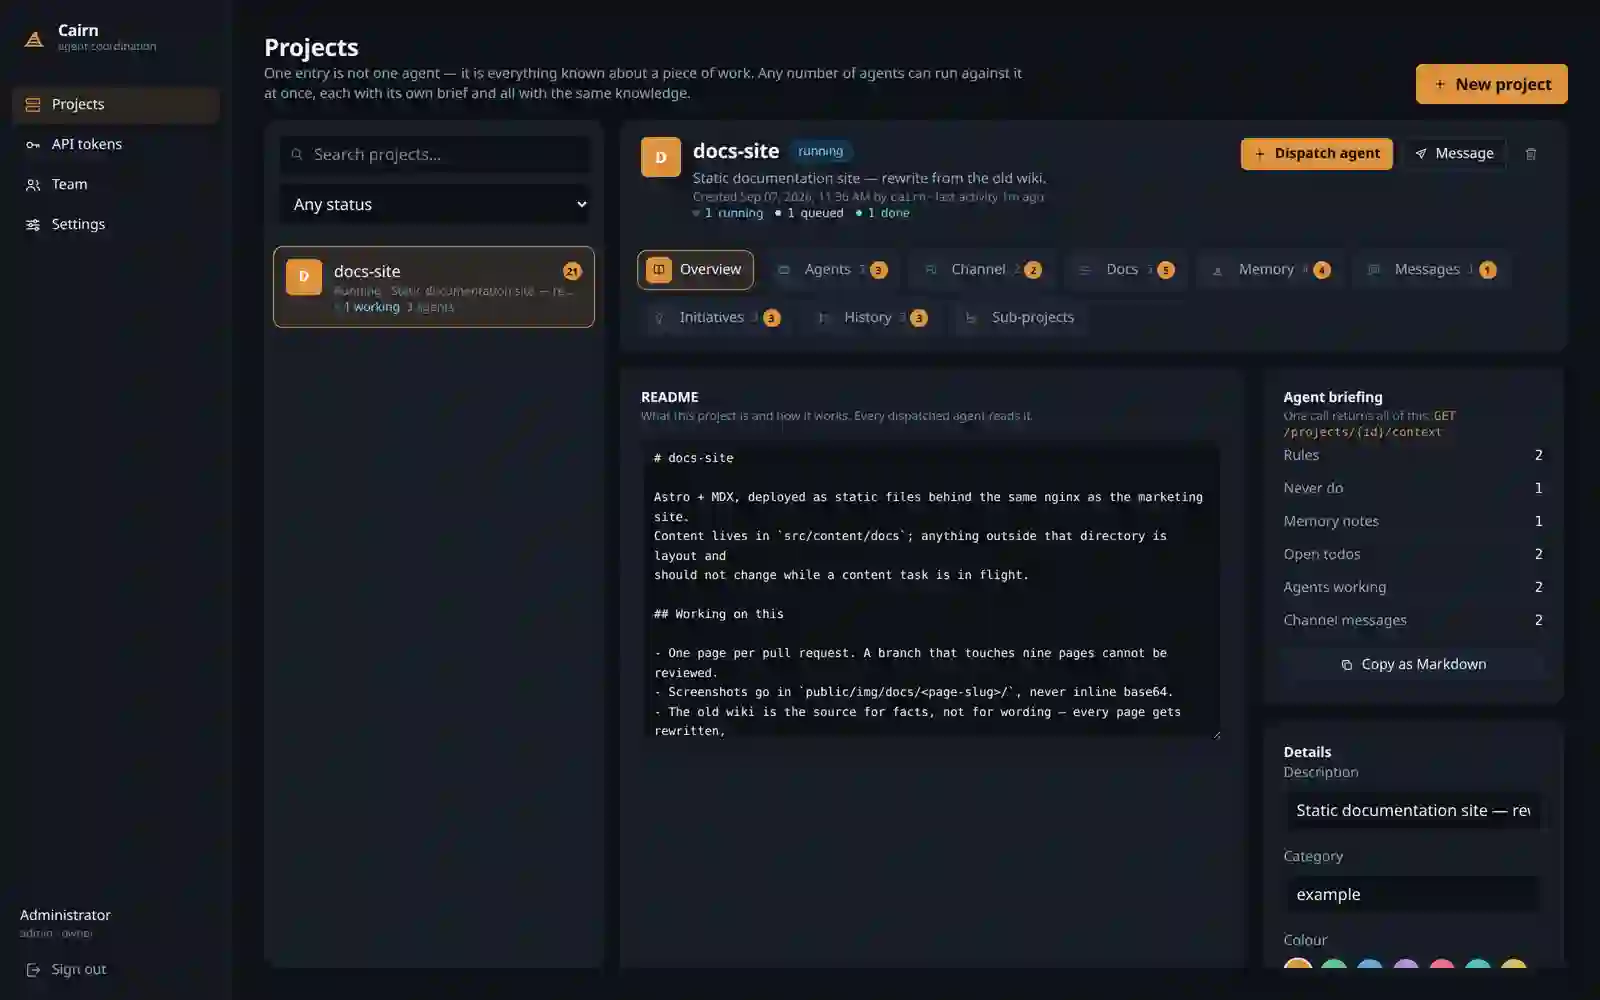
Self-hosted panel, w którym wiedza o projekcie przeżywa agentów, którzy nad nim pracują. Log koordynacyjny, nie runner: agenci czytają briefing i raportują wynik, a Ty nie tłumaczysz każdemu tego samego od nowa. Dla zespołów puszczających kilku agentów na ten sam kod.
Wprowadzenie
Kiedy nad jednym repo pracuje kilku agentów AI, wiedza o projekcie ma paskudny zwyczaj umierania razem z sesją, która się skończyła. Pierwszy agent poznał ukryte zależności, dowiedział się, która część kodu jest krucha, i ustalił, jak się tu deployuje. Potem sesja gaśnie i ta wiedza znika. Następnemu agentowi tłumaczysz to samo od początku, i kolejnemu, i jeszcze raz, aż stajesz się wąskim gardłem dla wiedzy o własnym projekcie.
To nie jest problem mocy obliczeniowej ani modelu. Żaden mocniejszy agent tego nie naprawi, bo to problem pamięci między sesjami, a nie w obrębie jednej. Cairn celuje dokładnie w to miejsce: trzyma briefing i historię ustaleń w jednym miejscu, które nie znika, kiedy agent kończy pracę. Świadomie jest to log, a nie kolejny orchestrator.
Wiedza, która umiera z sesją
Sesja agenta jest z natury ulotna. Zbiera kontekst, buduje na nim swoją pracę, a potem kończy się i cały ten kontekst paruje. Przy jednym agencie to żaden problem: pamiętasz go Ty. Przy pięciu, które wchodzą w to samo repo jeden po drugim albo równolegle, każdy zaczyna od zera i każdy odkrywa te same miny na nowo. Tę samą kruchą migrację, ten sam nieoczywisty deploy, tę samą zależność, która wywala się tylko w pewnej kolejności.
Naturalny odruch to spisać to w README albo wkleić w prompt. Tyle że README szybko się starzeje, a prompt ginie razem z oknem czatu. Potrzebne było miejsce, które rośnie razem z projektem i przeżywa poszczególne sesje: coś, do czego agent zagląda po kontekst na wejściu i do czego dopisuje, co zrobił, na wyjściu.
Log, nie runner
Łatwo było zrobić z tego kolejny orchestrator, który sam odpala agentów i próbuje nimi dyrygować. Odpuściliśmy to celowo, bo runnery mają przewidywalny los: wpinają się głęboko w twoje środowisko, zakładają o nim coraz więcej i szybko stają się rzeczą, która sama wymaga utrzymania. Zamiast dawać pamięć, zabierają czas.
Log koordynacyjny jest odwrotnie: prosty, pasywny i nie wchodzi nikomu w drogę. Agent nadal żyje tam, gdzie zwykle, w twoim terminalu czy pipeline, robi swoje we własnym środowisku, a Cairn tylko daje mu pamięć i miejsce na raport. Nie ma tu magii orchestracji, która działa na demie i sypie się na prawdziwym projekcie, bo nie ma orchestracji w ogóle.
Co trzyma, a czego świadomie nie
| Rola | Cairn robi to | Cairn tego nie robi |
|---|---|---|
| Kontekst | trzyma briefing i historię ustaleń | nie zgaduje kontekstu za Ciebie |
| Koordynacja | log wpisów per projekt, po kolei | nie odpala i nie zarządza procesami agentów |
| Hosting | stawiasz u siebie, dane zostają Twoje | nie wysyła Twojego kodu do cudzej chmury |
| Widoczność | jedno miejsce na to, co zrobione i otwarte | nie zastępuje Twojego repo ani CI |
Pętla briefing, praca, raport
Sercem jest log koordynacyjny per projekt. Zamiast trzymać wiedzę w głowie jednego agenta albo w jednej sesji czatu, zapisujesz ją raz jako briefing, a każdy kolejny agent zaczyna od jej przeczytania. Po skończonej pracy dopisuje własny wpis: co zrobił, jaki jest stan, co zostało otwarte dla następnego. Log rośnie i staje się pamięcią projektu, która nie zależy od tego, która sesja akurat żyje.
zakładasz projekt i opisujesz go raz: co to jest, gdzie są granice, na co uważać.
każdy nowy agent zaczyna od tego samego kontekstu, bez powtarzania go ręcznie.
robi swoje zadanie we własnym środowisku, bo Cairn go nie odpala ani nie ogranicza.
dopisuje wynik do logu: co zmienił, co działa, co zostało do zrobienia.
kolejny agent czyta briefing plus wszystkie raporty i wchodzi w pracę z pełnym obrazem.
Klucz jest w tym, że wpis nie jest swobodnym tekstem, tylko krótką strukturą ze stanem i listą tego, co otwarte dla następnego. Dzięki temu log da się czytać przez maszynę i przez człowieka tak samo szybko, a kolejny agent nie musi domyślać się, na czym stanęła poprzednia tura.
Skala, która rośnie z projektem
Różnica robi się widoczna dopiero na dystansie. Bez wspólnej pamięci koszt wprowadzenia każdego kolejnego agenta rośnie, bo za każdym razem tłumaczysz ręcznie coraz dłuższą historię projektu. Z Cairnem ten koszt jest płaski: pierwszy agent i dziesiąty czytają to samo źródło, więc wchodzą w pracę z tym samym obrazem, niezależnie od tego, który są po kolei.
To jest cała różnica między zespołem, który skaluje liczbę agentów, a zespołem, który tonie we własnym onboardingu. Pamięć, która przeżywa sesje, zamienia wiedzę o projekcie z czegoś, co trzeba za każdym razem odtworzyć, w coś, co po prostu jest.
Cicha warstwa pamięci
Zespół, który puszcza kilku agentów na ten sam kod, przestaje być wąskim gardłem dla własnej wiedzy. Briefing piszesz raz, a nie przy każdym nowym oknie czatu. Agent, który wchodzi jako trzeci, wie tyle samo co pierwszy, bo czyta to samo. Cairn nie jest efektowny i nie stara się być: jest cichą warstwą pamięci, której wcześniej brakowało między sesjami.
Ponieważ stawiasz go u siebie, ani kod, ani historia ustaleń nie wychodzą do cudzej chmury. Pamięć projektu zostaje tam, gdzie projekt: u Ciebie. To niepozorna warstwa, ale kiedy raz zaczniesz puszczać agentów seriami, trudno bez niej wrócić.
Pytania o Cairn

Więcej projektów
Inne realizacje z tej samej kategorii - zobacz, jak podchodzimy do podobnych wyzwań.