Co nie działało
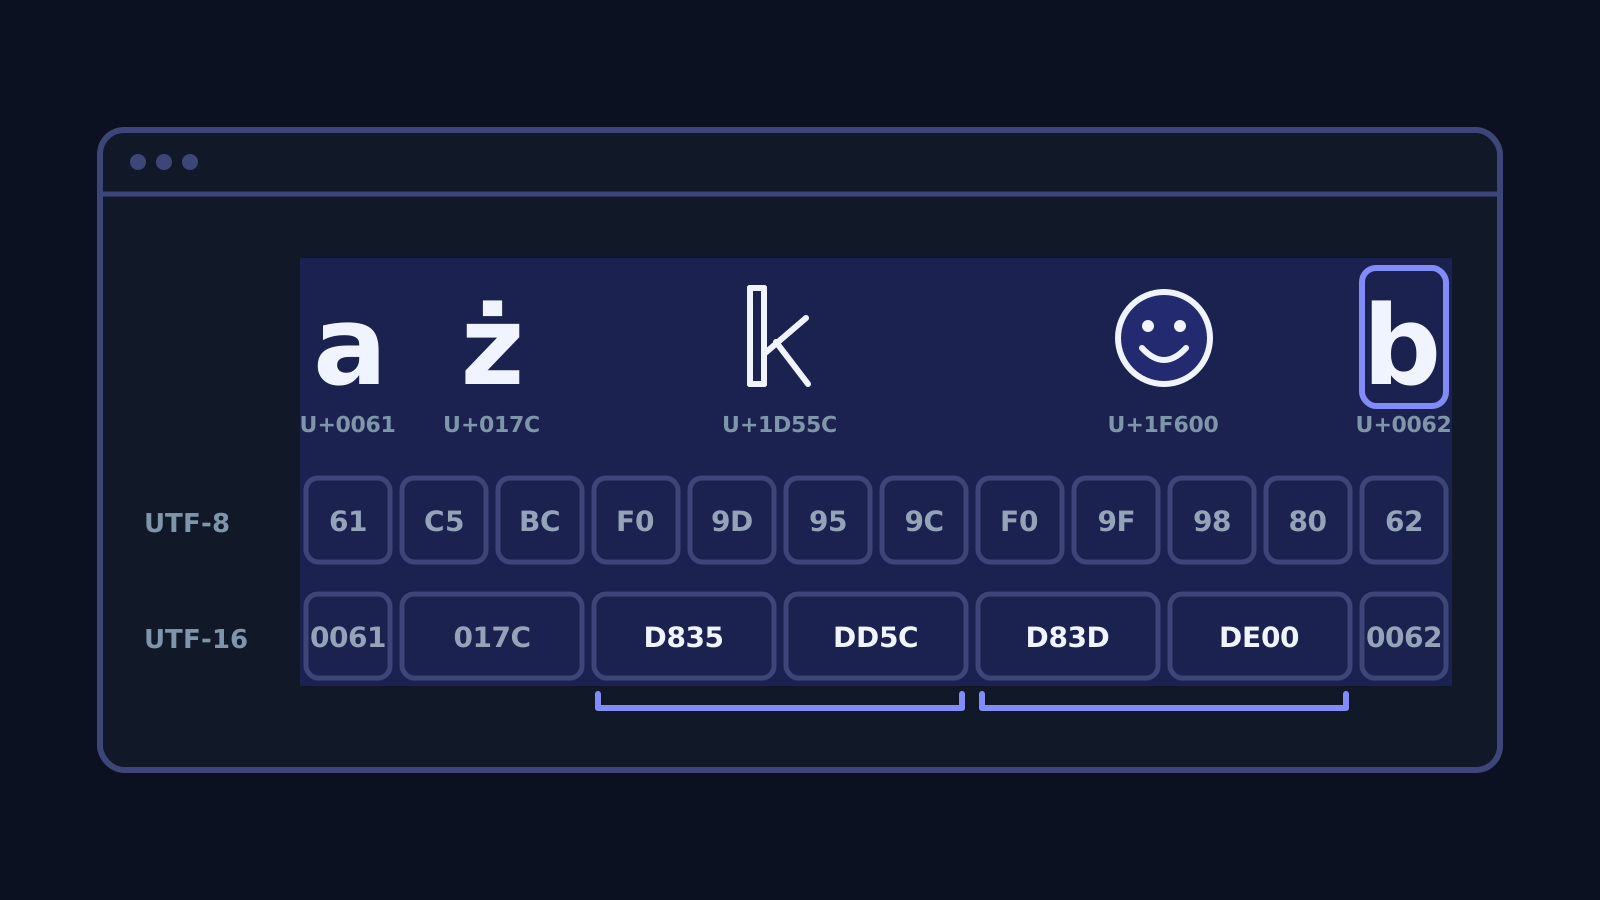
Rozszerzenie vscode-neovim uruchamia prawdziwego Neovima pod spodem VS Code. Neovim liczy kolumny w bajtach UTF-8, a VS Code w jednostkach UTF-16, więc każde zaznaczenie trzeba przeliczyć. Znaki spoza podstawowej płaszczyzny Unicode, takie jak większość emoji albo 𝕜 (U+1D55C), zajmują w UTF-16 dwie jednostki, tak zwaną parę surogatów.
W trybie visual koniec zaznaczenia jest włączny, a w VS Code wyłączny, więc kod dodawał do końcowej kolumny jedną jednostkę UTF-16. Przy znaku z dwóch jednostek zaznaczenie kończyło się w połowie pary (zgłoszenie #2535).
Co zmieniliśmy
Zamiast dodawać jedną jednostkę UTF-16, kod najpierw przesuwa koniec zaznaczenia o cały znak w bajtach, a dopiero potem przelicza kolumnę na UTF-16:
Funkcja byte_after_char korzysta z vim.str_utf_end, żeby znaleźć ostatni bajt znaku, i pilnuje końca linii.
Jak to sprawdziliśmy
Doszły trzy testy integracyjne: zaznaczenie nad jednym znakiem spoza BMP, nad dwoma takimi znakami pod rząd i nad mieszanką zwykłych znaków wielobajtowych z tymi spoza BMP. Pakietu integracyjnego nie dało się uruchomić lokalnie, co napisaliśmy w opisie, więc pierwszym przebiegiem było CI projektu.
Efekt
Zmianę scalono 23 września 2026. Zaznaczenia w tekstach z emoji i znakami matematycznymi obejmują teraz całe znaki.