Co nie działało
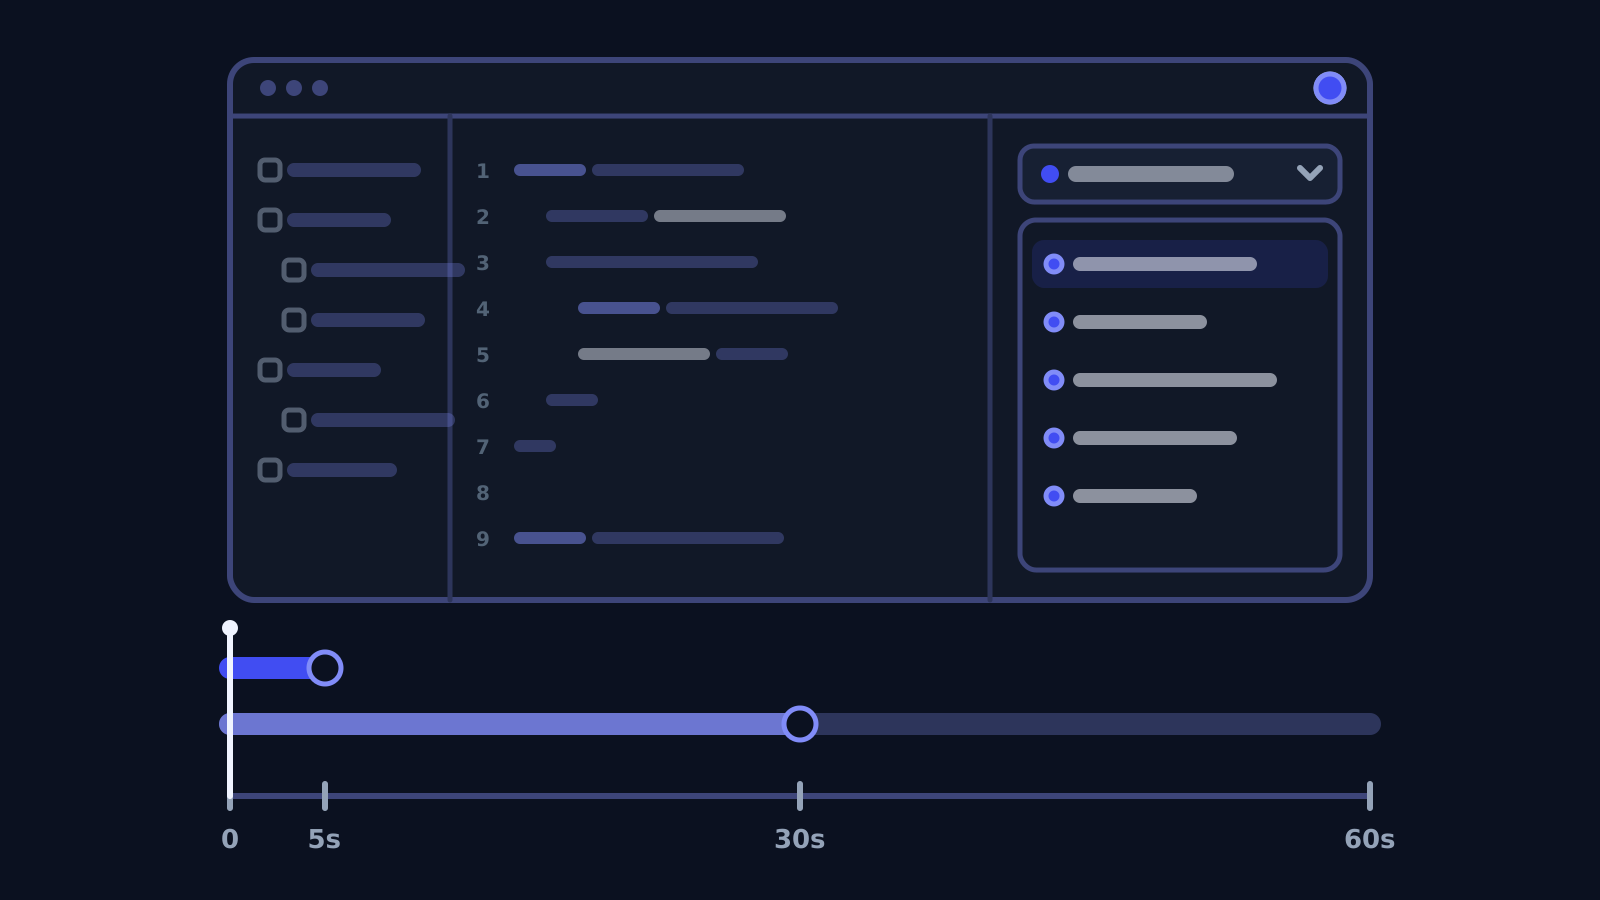
Zed, edytor kodu napisany w Rust, pozwala korzystać z modeli z subskrypcji ChatGPT. Po zalogowaniu pobiera katalog modeli dostępnych dla danego konta z endpointu /backend-api/codex/models. Dla części kont ta odpowiedź przychodzi po około 30 sekundach, a Zed przerywał zapytanie po 5. Wracał wtedy do wbudowanej listy modeli i z selektora znikały modele przypisane do konta (zgłoszenie #64173).
Samo wydłużenie limitu nie wchodziło w grę. Ładowanie danych logowania i samo logowanie czekają na wynik tego zapytania, więc użytkownik patrzyłby na zawieszony ekran przez pół minuty.
Co zmieniliśmy
Rozdzieliliśmy dwa limity czasu. Logowanie dalej czeka najwyżej 5 sekund, ale zapytanie nie jest przerywane: działa w tle do 60 sekund i podmienia listę modeli, kiedy wreszcie wróci.
Jeśli katalog zdąży w 5 sekund, wszystko działa jak wcześniej. Jeśli nie, odpięte zadanie kończy się później, a ewentualny błąd trafia tylko do logu, bez blokowania interfejsu.
Jak to sprawdziliśmy
Dodaliśmy test test_slow_model_catalog_does_not_block_initial_load z udawanym klientem HTTP, który wstrzymuje odpowiedź. Pierwsze ładowanie kończy się po 5 sekundach z wbudowanymi modelami, a odpowiedź, która przychodzi 30 sekund później, podmienia listę na modele konta. Przeszły też cargo test i clippy dla tej paczki. Na prawdziwym endpointcie zmiana nie była testowana i napisaliśmy to wprost w opisie pull requesta.
Efekt
Zmianę scalono do gałęzi main 1 października 2026. Wpis do notatek wydania opisuje ją jako poprawkę znikających modeli z subskrypcji ChatGPT, gdy katalog ładuje się dłużej niż 5 sekund.