
Audyt SEO technicznego i Core Web Vitals
Sprawdzamy to, czego nie poprawi samo pisanie treści: indeksowanie, przekierowania, dane strukturalne i Core Web Vitals. Wyniki mierzymy na danych użytkowników, a poprawki wprowadzamy w kodzie, zamiast oddać PDF z zaleceniami.
Kiedy audyt ma sens
Audyt jest dla serwisów, które mają treść, ale Google jej nie pokazuje albo pokazuje za nisko. Zajmujemy się tym, jak strona jest zbudowana, a nie pisaniem treści i zdobywaniem linków.
Z czym przychodzą klienci
- Spadek ruchuRuch z Google spadł po zmianie strony albo bez widocznego powodu.IndeksowanieStruktura
- Wolna stronaCzerwone Core Web Vitals w Search Console i długie ładowanie na telefonie.Szybkość
- Strony poza indeksemStatus "wykryto, nie zindeksowano" przy ważnych podstronach.Indeksowanie
- Kilka językówHreflang, który Google ignoruje, i wersje językowe konkurujące ze sobą.StrukturaStrony wielojęzyczne
- Sklep internetowyFiltry i warianty, które tworzą tysiące zbędnych adresów.IndeksowanieDane strukturalne
- Nowa strona przed startemStart w Google psują ustawienia z wersji testowej: noindex, blokada w robots.txt albo canonical na adres testowy.IndeksowanieLista przed startem
Gdzie szukamy przyczyny
- IndeksowanieRobots.txt i mapa strony, adresy kanoniczne, przekierowania i strony poza indeksem.Sygnały nie mogą sobie przeczyć, na przykład mapa strony z adresami, które przekierowują.
- StrukturaNagłówki i linki wewnętrzne, duplikaty treści, hreflang przy kilku językach.Przejście tylko skryptem, bez adresu w linku, robota nigdzie nie prowadzi.
- Dane strukturalneFirma, produkty, artykuły i pytania, sprawdzone w narzędziach Google.Pełne dane produktu, z ceną i dostępnością, dają Google więcej do pokazania w wynikach.
- SzybkośćLCP, INP i CLS z danych użytkowników, pomiary laboratoryjne.Oceniamy dane prawdziwych użytkowników, bo tak robi Google.
Szybkość: progi Core Web Vitals
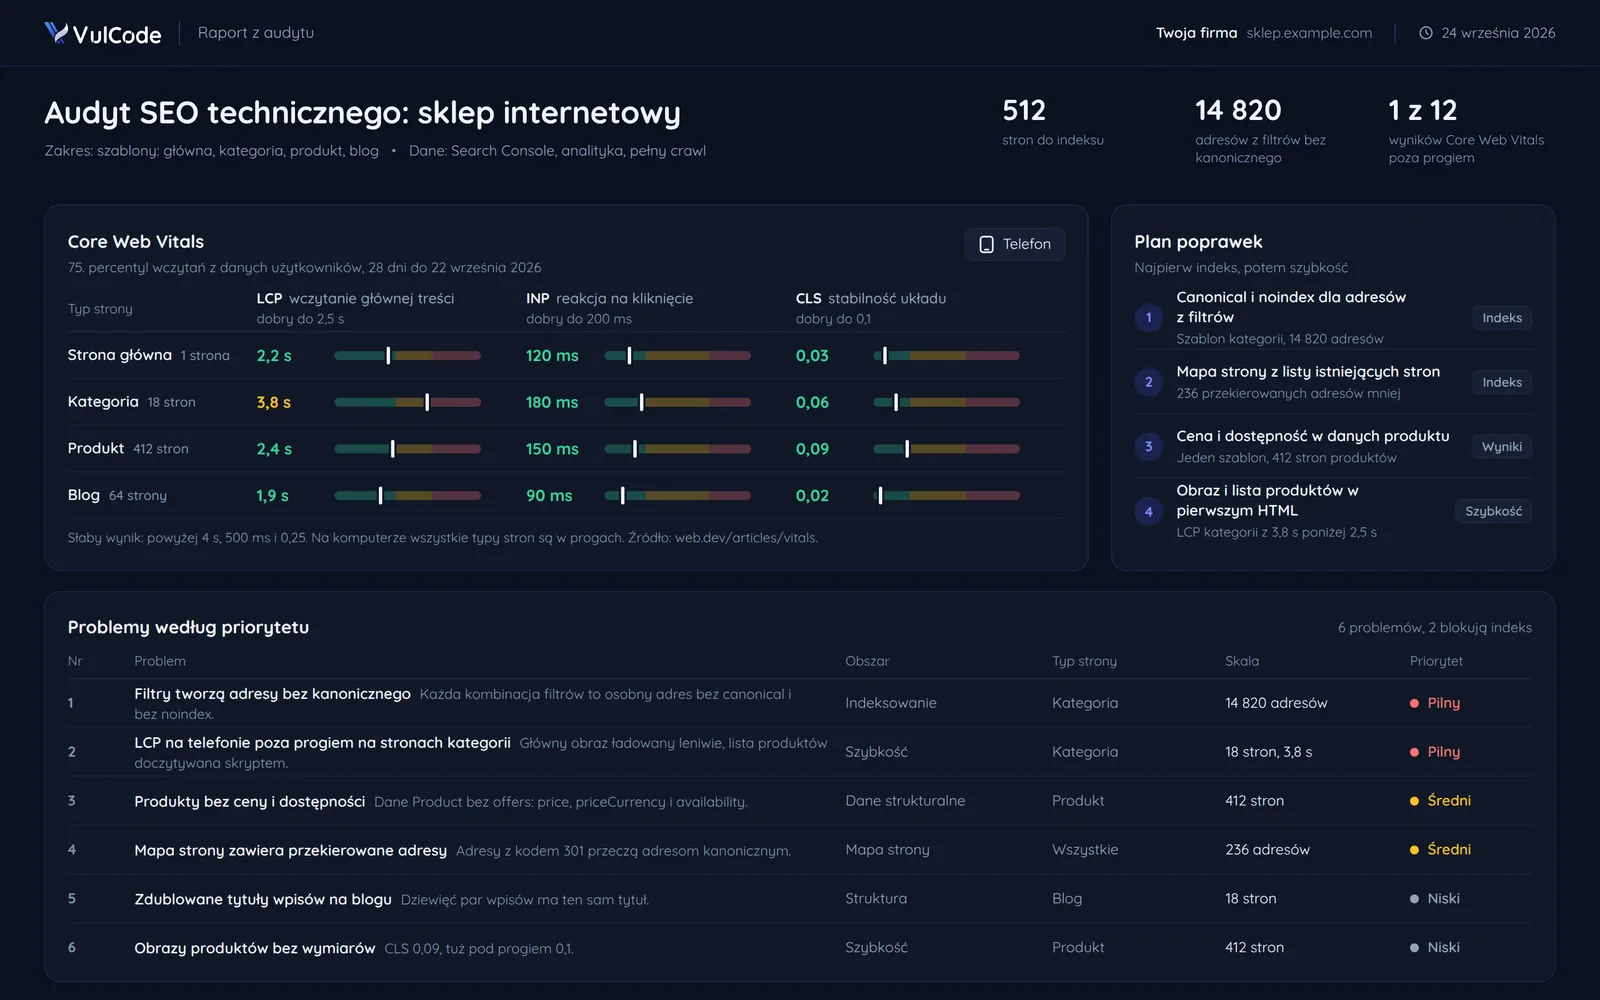
Google ocenia stronę na 75. percentylu wczytań, osobno na telefonie i komputerze. Dlatego patrzymy na dane prawdziwych użytkowników, a nie na jeden pomiar. Progi: dobry wynik do 2,5 s, 200 ms i 0,1, słaby powyżej 4 s, 500 ms i 0,25. Techniki z kodem: Core Web Vitals w praktyce.
LCP
wczytanie głównej treści- Strona główna1 strona2,2 s
- Kategoria18 stron3,8 s
- Produkt412 stron2,4 s
- Blog64 strony1,9 s
Treść w pierwszym HTML, główny obraz pobierany od razu z wysokim priorytetem, obrazy w AVIF i WebP we właściwym rozmiarze, a te poniżej pierwszego ekranu ładowane dopiero wtedy, gdy są widoczne.
INP
reakcja na kliknięcie- Strona główna1 strona120 ms
- Kategoria18 stron180 ms
- Produkt412 stron150 ms
- Blog64 strony90 ms
Ciężkie skrypty i blokowanie głównego wątku: najpierw widoczna reakcja na kliknięcie, potem obliczenia w krótkich kawałkach, a skrypty zewnętrzne dopiero po wczytaniu strony.
CLS
stabilność układu- Strona główna1 strona0,03
- Kategoria18 stron0,06
- Produkt412 stron0,09
- Blog64 strony0,02
Wymiary obrazów, czcionki z krojem zastępczym o tych samych proporcjach i baner cookies, który nakłada się na treść, zamiast spychać ją w dół.
Co widzi Google, gdy strona to aplikacja w JavaScript
Według dokumentacji Google robot najpierw pobiera HTML, a renderowanie czeka w kolejce. Strony w React i innych SPA często dają w pierwszym HTML pusty kontener. Google pisze, że renderowanie na serwerze albo prerender to wciąż dobry pomysł, bo strona jest szybsza dla ludzi i robotów. Przy przejściu na prerender często zmieniają się też adresy. Wtedy łączymy to z migracją i mapą przekierowań.
SPA bez prerenderu
Bez tego strona do czasu renderowania wygląda na pustą, a nie każdy robot uruchamia JavaScript.
Pobranie HTMLPusty kontenerKolejka renderowaniaCzeka w kolejceRenderowanieSkrypty dokładają treśćIndeksTreść i linki dopiero teraz- Treść w pierwszym HTML: nie
- Działa dla robotów bez JavaScript: nie
- Interaktywna aplikacja: tak
- Szybkie pierwsze wczytanie: częściowo
Prerender albo SSR
Z prerenderem albo renderowaniem na serwerze treść jest już w pierwszym HTML, więc robot nie musi czekać na skrypty.
Pobranie HTMLTreść i linki od razuKolejka renderowaniaBez czekania w kolejceRenderowanieBez czekania na skryptyIndeksTreść i linki z pierwszej odpowiedziPrerender, który po cichu nie działaPodstrony ładowane leniwie przez React.lazy potrafią trafić do HTML z serwera jako pusty znacznik, bez błędu w konsoli. U siebie przed właściwym renderowaniem przechodzimy raz po wszystkich trasach, żeby każdy taki moduł zdążył się wczytać.- Treść w pierwszym HTML: tak
- Działa dla robotów bez JavaScript: tak
- Interaktywna aplikacja: tak
- Szybkie pierwsze wczytanie: tak
Statyczny HTML
Gotowy plik HTML: robot dostaje wszystko w pierwszej odpowiedzi, ale aplikacja jest interaktywna tylko częściowo.
Pobranie HTMLTreść i linki od razuKolejka renderowaniaBez czekania w kolejceRenderowanieBez czekania na skryptyIndeksTreść i linki z pierwszej odpowiedzi- Treść w pierwszym HTML: tak
- Działa dla robotów bez JavaScript: tak
- Interaktywna aplikacja: częściowo
- Szybkie pierwsze wczytanie: tak
Jak sprawdzamy pierwszy HTML
Sprawdzamy HTML, który serwer wysyła, zanim uruchomią się skrypty, bo tylko na nim można polegać przy indeksowaniu. Tą samą kontrolą sprawdzamy wszystkie strony vulcode.com i ustawiamy ją w Twoim projekcie. W pierwszym HTML kategorii nazwa produktu nie pada ani razu, bo lista produktów dochodzi dopiero skryptem.
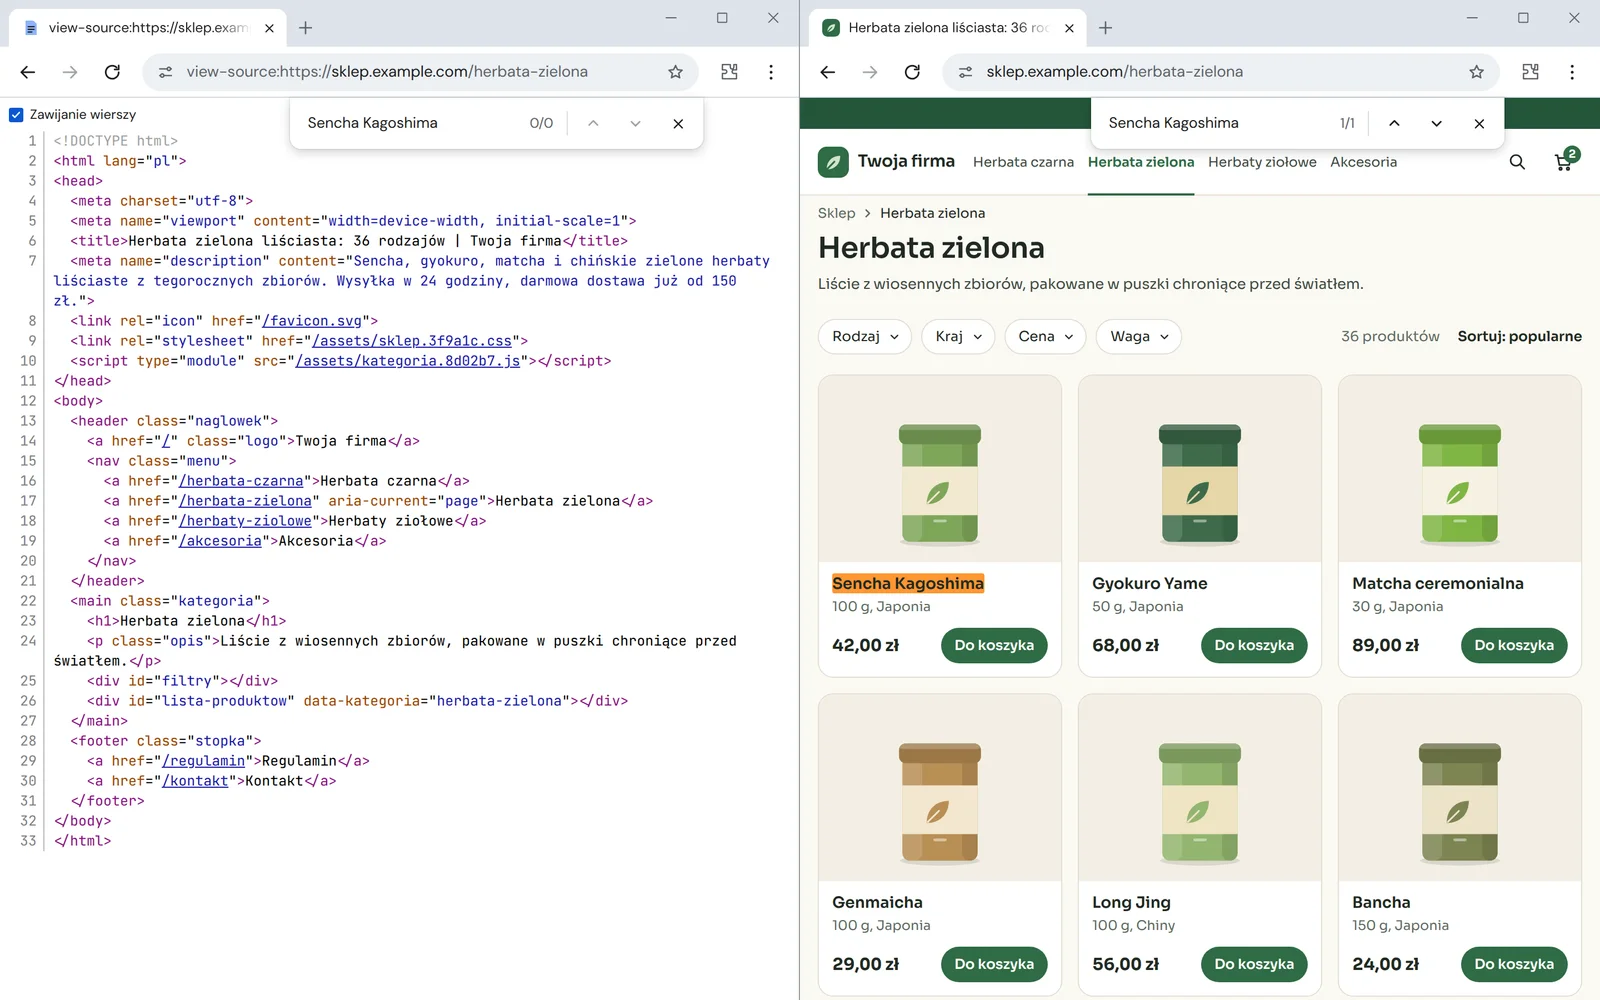
- Tytuł52 znaki, limit 45-60Granice długości tytułu i opisu, w których Google zwykle pokazuje je w całości.
- Opis137 znaków, limit 135-155Opis mieści się w granicach, w których Google zwykle pokazuje go w całości.
- Nagłówek H1jedenDokładnie jeden nagłówek H1 na stronę.
- Adres kanonicznybrakKażda indeksowana strona ma adres kanoniczny. Tu go brakuje, więc każdy filtr kategorii tworzy osobny adres.
- Lista produktówpusty kontenerKontrola na gotowym HTML, czyli na tym, co robot dostaje przed uruchomieniem skryptów. Lista produktów dochodzi dopiero skryptem.
Pełna wersja sprawdza też hreflang, to, czy canonical i hreflang prowadzą do istniejących stron, zdublowane tytuły i opisy, podwójne bloki FAQPage, nagłówek H1 zakończony kursorem animacji, półpauzy i drukarskie cudzysłowy w tytule i opisie oraz linki wewnętrzne do stron, których nie ma.
Jak wygląda raport z audytu
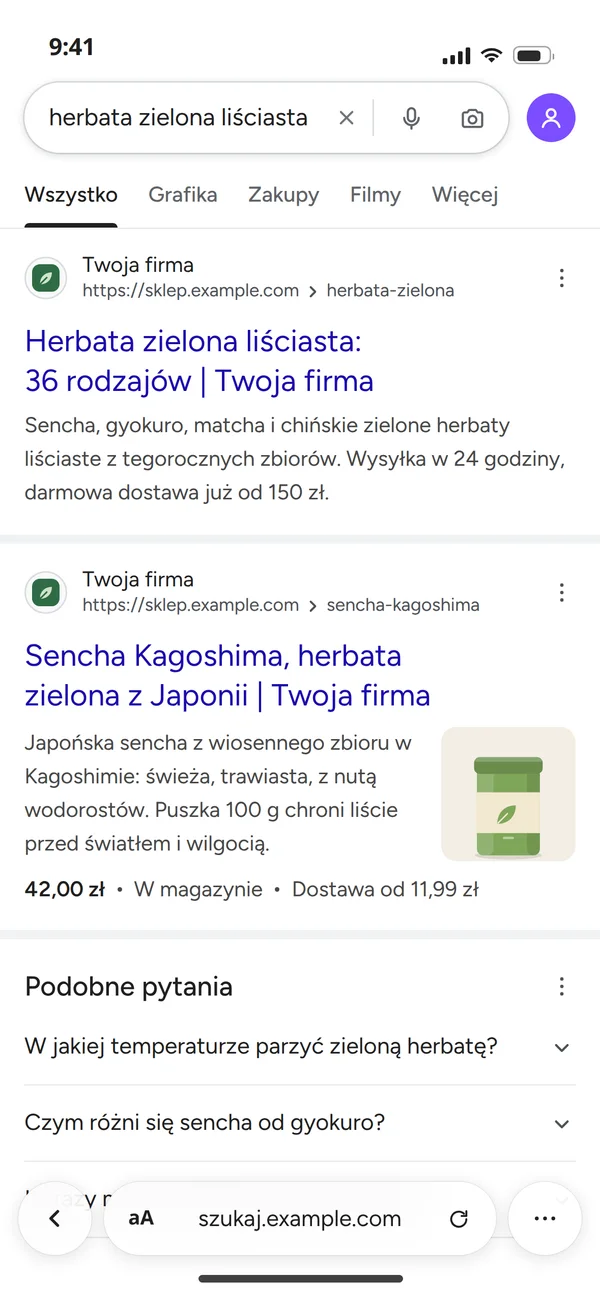
Raport kończy się planem: problemy po kolei, najpierw to, co blokuje indeks, na końcu szybkość. Obok, co ten plan zmienia w wynikach wyszukiwania. Po poprawkach kategoria ma w wynikach pełny tytuł i opis z pierwszego HTML, a produkt cenę i dostępność z danych strukturalnych.
- Najpierw indeksIndeksowanie: filtry tworzą adresy bez kanonicznegoPilny14 820 adresów, szablon kategorii
Problemy, które blokują indeks albo tworzą tysiące zbędnych adresów, mają najwyższy priorytet.
- Mapa strony: zawiera przekierowane adresyŚredni236 adresów
Mapa strony, kanoniczne adresy i przekierowania nie mogą sobie przeczyć.
- Potem wynikiDane strukturalne: produkty bez ceny i dostępnościŚredni412 stron produktów
Pełne dane produktu w schema dają Google więcej informacji do pokazania w wynikach.
- Na końcu szybkośćLCP na telefonie: poza progiem na stronach kategoriiPilny18 stron kategorii, 3,8 s
Poprawka w szablonie kategorii naprawia setki stron naraz, więc wynik podajemy dla typu strony.
Nasza strona jako dowód
vulcode.com to aplikacja React, a każdy jej adres ma pełny HTML wygenerowany przed publikacją. Liczby pochodzą z naszego pomiaru: pierwszy HTML wszystkich polskich i angielskich adresów z mapy strony i pięć stron otwartych w przeglądarce bez okna.
- TreśćTekst strony jest w HTML, zanim zadziała JavaScript.
- Tytuł i opisKażdy adres ma własny tytuł i opis w wynikach.
- CanonicalWskazuje ten sam adres, pod którym strona stoi.
- HreflangWersja polska i angielska wskazują na siebie nawzajem.
Pierwszy HTML wszystkich adresów z mapy strony, pobrany z identyfikatorem Googlebota.
| 390 px | 768 px | 1440 px | |
|---|---|---|---|
| /pl | |||
| /pl/oferty | |||
| /pl/oferty/website | |||
| /pl/platformy | |||
| /pl/portfolio |
- 0 błędów w konsoli przeglądarki
- 0 obrazów bez tekstu alternatywnego
- 0 linków bez adresu, pustych albo z samym #
VulCode
SPA w React 19 i Vite z renderowaniem na serwerze, w dwóch wersjach językowych z hreflang i osobnymi adresami.
- Jedna lista trasZ niej powstaje gotowy HTML każdego adresu i mapa strony.
- Pełny HTML każdego adresuLinki to zwykłe znaczniki z adresem, a JavaScript startuje, gdy treść jest już na ekranie, i ładuje tylko kod tej strony.
- Kompresja przy budowieBrotli i gzip na najwyższym poziomie, raz, więc serwer nic nie kompresuje w locie.
- Mapa strony z listy trasPodaje tylko adresy, które naprawdę istnieją.
Jak przebiega praca nad SEO technicznym
Pomiar, lista problemów, poprawki w kodzie i pomiar jeszcze raz.
Zbieramy dane z Search Console, analityki i pomiarów szybkości oraz robimy pełny crawl serwisu. Szybkość mierzymy w trybie mobilnym i kilka razy z rzędu, bo wynik zmienia się między uruchomieniami o kilka punktów.
Sprawdzamy indeksowanie i kanoniczne adresy, nagłówki i linki wewnętrzne, dane strukturalne i szybkość każdego typu strony.
Najpierw to, co blokuje indeks, potem szybkość. Każdy problem ma priorytet według wpływu na ruch i kosztu poprawki.
Obrazy i czcionki, renderowanie treści, mapa strony i przekierowania, najpierw na wersji testowej, po akceptacji na produkcji. Dzięki temu żadna poprawka nie zablokuje indeksu przez pomyłkę.
Porównujemy wyniki przed i po, a w Search Console zgłaszamy poprawki i pilnujemy, aż Google je przetworzy. Wyniki szybkości dostajesz jako link do raportu PageSpeed Insights, który możesz uruchomić ponownie sam.
- Dostępy i pomiar
Zbieramy dane z Search Console, analityki i pomiarów szybkości oraz robimy pełny crawl serwisu. Szybkość mierzymy w trybie mobilnym i kilka razy z rzędu, bo wynik zmienia się między uruchomieniami o kilka punktów.
dostajesz: Punkt wyjścia w liczbach - Audyt
Sprawdzamy indeksowanie i kanoniczne adresy, nagłówki i linki wewnętrzne, dane strukturalne i szybkość każdego typu strony.
dostajesz: Raport z priorytetami - Plan poprawek
Najpierw to, co blokuje indeks, potem szybkość. Każdy problem ma priorytet według wpływu na ruch i kosztu poprawki.
Obrazy na stronach produktówza ciężkie na telefoniedostajesz: Wycena wdrożenia - Poprawki w kodzie
Obrazy i czcionki, renderowanie treści, mapa strony i przekierowania, najpierw na wersji testowej, po akceptacji na produkcji. Dzięki temu żadna poprawka nie zablokuje indeksu przez pomyłkę.
Strony poza indeksemnoindex przeniesiony z wersji testowejdostajesz: Zmiany na produkcji - Pomiar po zmianach
Porównujemy wyniki przed i po, a w Search Console zgłaszamy poprawki i pilnujemy, aż Google je przetworzy. Wyniki szybkości dostajesz jako link do raportu PageSpeed Insights, który możesz uruchomić ponownie sam.
Szybkość strony głównejten sam pomiar co na starcieporównanie z pomiarem z kroku: Dostępy i pomiardostajesz: Raport końcowy
Najczęstsze pytania o SEO techniczne
Odpowiedzi o zakresie audytu, efektach i wycenie.

Czytaj dalej
Usługi, które często idą razem z SEO technicznym, i nasze poradniki o tym, co sprawdzamy.
Google nie pokazuje Twoich stron?
Napisz adres strony i co się zmieniło. Odpowiemy w godzinę z pytaniami i wyceną audytu.